Quelle est la meilleure synthèse vocale en français ? La question se pose à chaque projet d’assistant vocal, de serveur vocal interactif ou de lecture automatique de documents, et les réponses disponibles reposent le plus souvent sur une écoute de quelques phrases de démonstration. Nous avons préféré mesurer. Huit moteurs ont lu les mêmes 36 phrases, choisies pour piéger une voix de synthèse (montants, dates, sigles, anglicismes techniques, noms propres) : quatre modèles ouverts exécutés sur un Mac, Voxtral TTS de Mistral, Fish Audio S2 Pro, Kokoro et Piper ; Phonon, servi par Ollama ; la voix système de macOS ; et deux voix d’Azure AI Speech comme référence cloud. Chaque audio a été retranscrit par un modèle de reconnaissance vocale pour compter les mots mal lus, et nous avons mesuré la réactivité, la vitesse et la mémoire. Les licences, enfin, changent tout pour un usage professionnel.
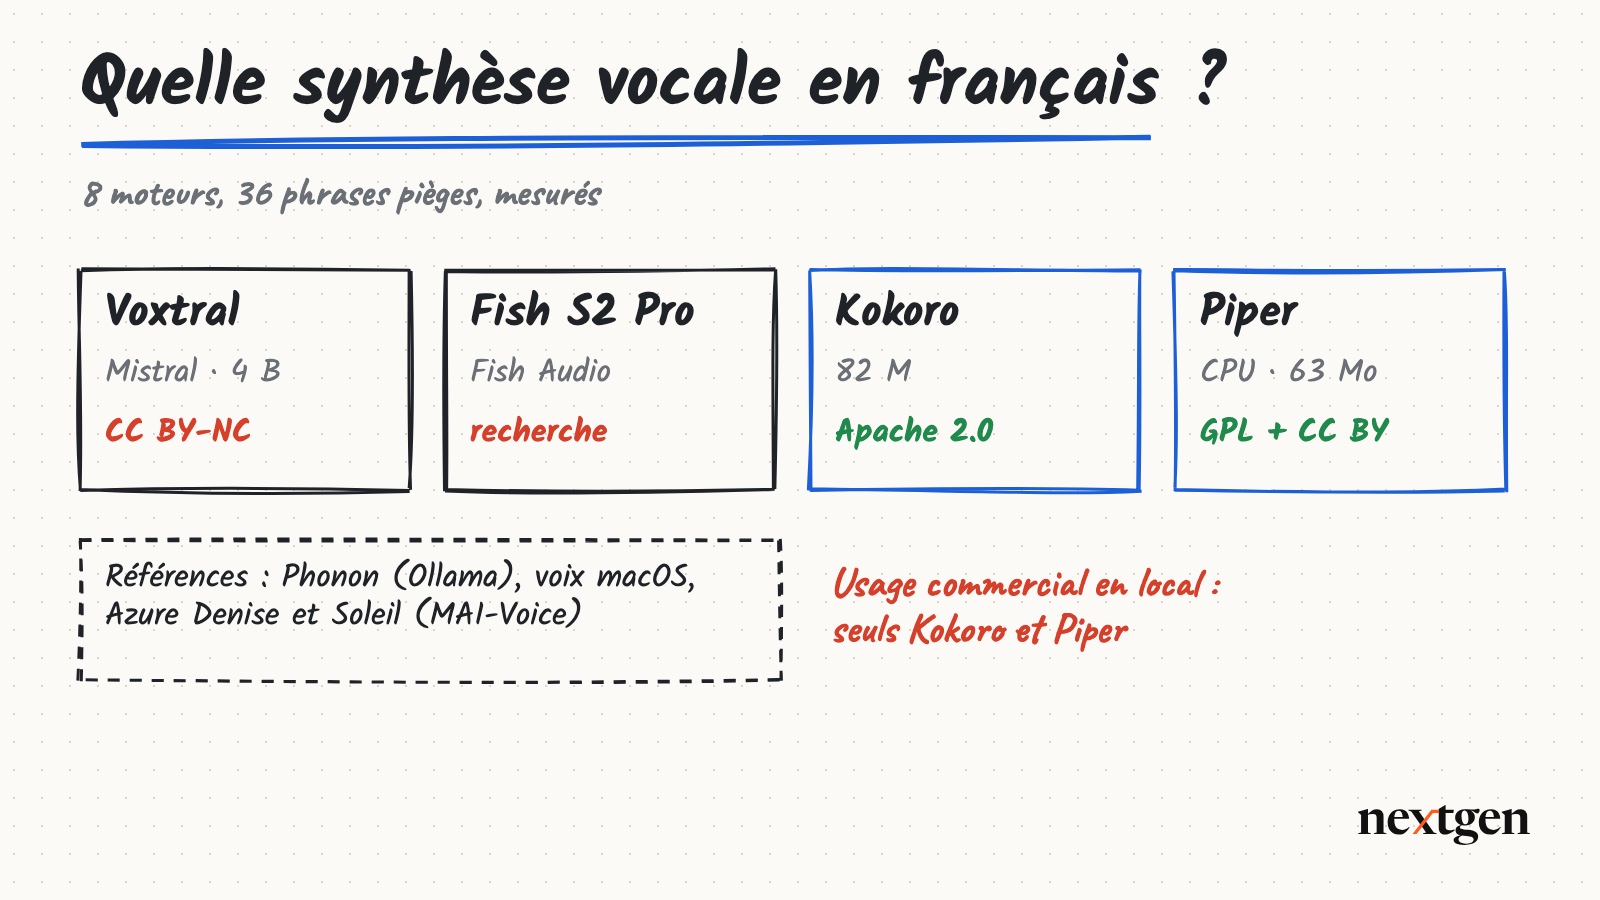
Les huit moteurs comparés
| Moteur | Éditeur | Taille | Exécution | Licence | Usage commercial |
|---|---|---|---|---|---|
| Voxtral 4B TTS | Mistral AI | 4 milliards de paramètres (4 bits : environ 2,5 Go) | Mac, MLX | CC BY-NC 4.0 | non, sans accord |
| Fish Audio S2 Pro | Fish Audio | 11 Go (8 bits : 6,7 Go) | Mac, MLX | Fish Audio Research License | non, licence séparée |
| Kokoro 82M | hexgrad | 82 millions de paramètres | Mac, MLX | Apache 2.0 | oui |
| Piper (voix siwis) | Open Home Foundation | 63 Mo | CPU, ONNX | moteur GPL-3.0, voix CC BY 4.0 | oui, avec attribution |
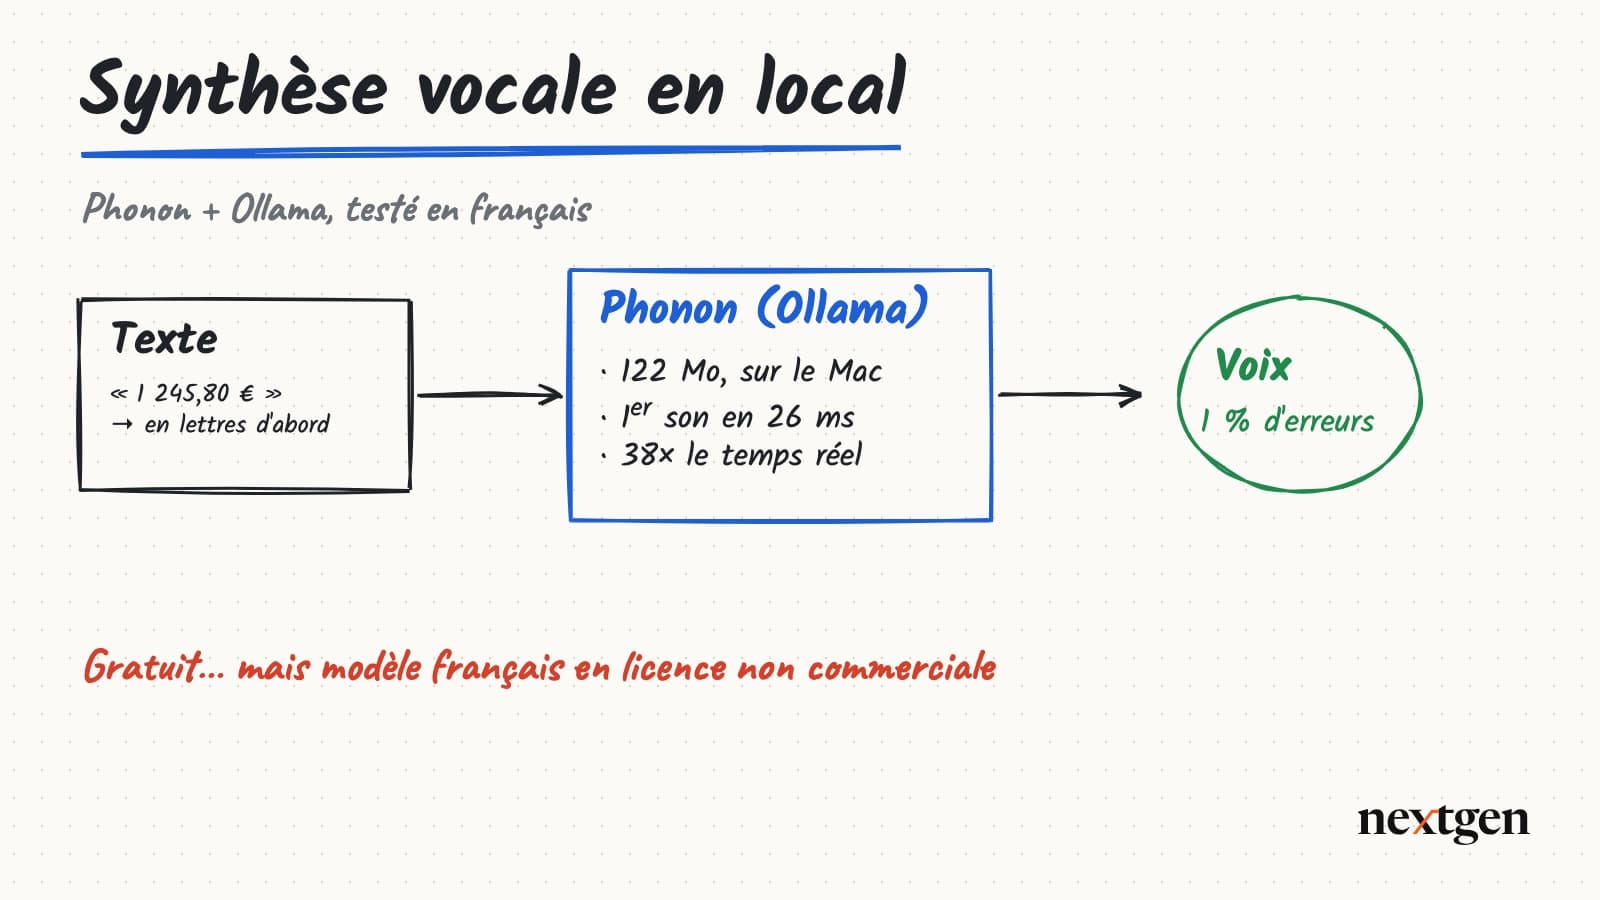
Phonon fr |
Gradium | 122 Mo | Mac, Ollama | CC BY-NC 4.0 | non, sans accord |
| Voix « Thomas » | Apple | intégrée | macOS | licence de macOS | selon la licence du système |
| Azure Denise (neuronale) | Microsoft | – | cloud | service payant | oui, 15 $ par million de caractères |
| Azure Soleil (MAI-Voice-2.1-Flash) | Microsoft | – | cloud | service payant | oui |
Un neuvième candidat a été écarté faute de mémoire : Fish Audio Drama 3, publié le 1er octobre 2026, est un modèle de 35 milliards de paramètres (3 milliards actifs) dont les poids pèsent 41,5 Go ; même quantifié en 4 bits pour MLX, il occupe 23,8 Go et ne tient pas dans un Mac de 24 Go. Il relève d’un serveur GPU.
Le protocole de test
Le banc a été exécuté sur un Mac Apple Silicon M5 Pro doté de 24 Go de mémoire unifiée. Les modèles MLX sont servis par la bibliothèque mlx-audio 0.6.4, Piper par piper-tts sur le processeur, Phonon par Ollama 0.40.13, et les voix d’Azure par l’API REST d’Azure AI Speech, depuis la France vers la région Europe du Nord. Pour chaque phrase, nous mesurons :
- la fidélité : l’audio est retranscrit par gpt-4o-transcribe, puis comparé au texte d’origine ; le taux d’erreur sur les mots (WER) mesure ce qu’un auditeur aurait compris de travers. Les deux textes sont normalisés au préalable (nombres en lettres, ponctuation retirée) ;
- la réactivité : le délai avant le premier son ;
- la vitesse : la durée de l’audio rapportée au temps de génération (« 10 × » signifie dix secondes d’audio produites en une seconde) ;
- la mémoire : le pic de mémoire des modèles MLX pendant la série.
La mesure porte sur l’intelligibilité, pas sur le naturel de la voix : celui-ci s’apprécie à l’oreille, et les extraits audio plus bas permettent d’en juger. Chaque phrase n’a été lue qu’une fois ; d’une série à l’autre, le taux d’erreur d’un même moteur varie d’environ un demi-point, la génération n’étant pas déterministe.
Installer les moteurs
python3.12 -m venv .venv && source .venv/bin/activate
pip install mlx-audio==0.6.4 "mistral-common" "misaki[en]" piper-tts soundfile jiwer num2words httpx openai
brew install espeak-ng              # phonétiseur utilisé par Kokoro et Piper

# Voix françaises de Piper
python -m piper.download_voices --download-dir voix-piper fr_FR-siwis-medium

# Phonon, par Ollama (voir notre test dédié)
ollama pull phonon:fr
Deux pièges à l’installation : Kokoro échoue sans le paquet misaki et sans espeak-ng, et Voxtral refuse de charger son tokenizer sans mistral-common. Les deux messages d’erreur sont explicites, mais aucune des dépendances n’est installée avec mlx-audio. Les modèles MLX sont téléchargés depuis Hugging Face au premier appel ; Fish S2 Pro a mis près de trois minutes à se charger la première fois.
Le principe d’utilisation est le même pour les trois modèles MLX :
from mlx_audio.tts.utils import load_model

voxtral = load_model("mlx-community/Voxtral-4B-TTS-2603-mlx-4bit")
for segment in voxtral.generate("Votre rendez-vous est confirmé.", voice="fr_female"):
    audio, frequence = segment.audio, segment.sample_rate

kokoro = load_model("mlx-community/Kokoro-82M-bf16")
for segment in kokoro.generate("Votre rendez-vous est confirmé.", voice="ff_siwis", lang_code="f"):
    ...
Voxtral propose deux voix françaises (fr_female, fr_male) parmi vingt voix de référence ; Kokoro, une seule (ff_siwis). Fish S2 Pro n’a pas de voix prédéfinie : sans extrait de référence, il choisit lui-même un timbre, qui peut varier d’une phrase à l’autre ; en production, on lui fournit un court enregistrement à imiter.
Le script de mesure
Le corpus est le même que celui de notre test de Phonon : 36 phrases en huit catégories. Le script charge chaque moteur une fois, lit tout le corpus, retranscrit chaque fichier et produit les tableaux ci-dessous.
"""Banc d'essai de synthèse vocale en français : modèles ouverts sur Mac, voix système et cloud.
Pour chaque phrase du corpus et chaque moteur :
vitesse -> délai avant le premier son, durée de génération, facteur de temps réel
fidélité -> l'audio est retranscrit par un modèle de reconnaissance vocale, puis comparé au texte
(taux d'erreur sur les mots, WER, et sur les caractères, CER), par catégorie
mémoire -> pic de mémoire du moteur MLX pendant la série
Usage :
export AOAI_ENDPOINT=… AOAI_KEY=… SPEECH_KEY=… TTS_REGION=…
python bench.py # tous les moteurs
MOTEURS=kokoro,piper python bench.py # un sous-ensemble ; les autres résultats sont conservés
"""
import json
import os
import re
import statistics
import subprocess
import time
import wave
from pathlib import Path
import httpx
import jiwer
import mlx.core as mx
import numpy as np
import soundfile as sf
from num2words import num2words
from openai import AzureOpenAI
ICI = Path(__file__).parent
AUDIO = ICI / "audio"
AUDIO.mkdir(exist_ok=True)
CORPUS = json.loads((ICI / "corpus.json").read_text())
# nom -> (type, modèle, voix)
MOTEURS = {
"voxtral": ("mlx", "mlx-community/Voxtral-4B-TTS-2603-mlx-4bit", "fr_female"),
"fish-s2-pro": ("mlx", "mlx-community/fish-audio-s2-pro-8bit", None),
"kokoro": ("mlx", "mlx-community/Kokoro-82M-bf16", "ff_siwis"),
"piper": ("piper", "voix-piper/fr_FR-siwis-medium.onnx", None),
"phonon": ("ollama", "phonon:fr", None),
"macos": ("macos", None, "Thomas"),
"azure-denise": ("azure", None, "fr-FR-DeniseNeural"),
"azure-soleil-mai": ("azure", None, "fr-FR-Soleil:MAI-Voice-2.1-Flash"),
}
CHOIX = os.environ["MOTEURS"].split(",") if os.environ.get("MOTEURS") else list(MOTEURS)
stt = AzureOpenAI(azure_endpoint=os.environ["AOAI_ENDPOINT"], api_key=os.environ["AOAI_KEY"], api_version="2025-03-01-preview")
STT = os.environ.get("STT_DEPLOYMENT", "gpt-4o-transcribe")
class Moteur:
"""Charge un moteur une fois ; synthese() renvoie (échantillons float32, fréquence, délai du premier son)."""
def __init__(self, nom: str):
self.type, self.modele, self.voix = MOTEURS[nom]
if self.type == "mlx":
from mlx_audio.tts.utils import load_model
self.m = load_model(self.modele)
elif self.type == "piper":
from piper import PiperVoice
self.m = PiperVoice.load(str(ICI / self.modele))
def synthese(self, texte: str) -> tuple[np.ndarray, int, float]:
debut = time.perf_counter()
if self.type == "mlx":
options = {"voice": self.voix} if self.voix else {}
if "Kokoro" in self.modele:
options["lang_code"] = "f"
morceaux, premier, sr = [], None, 24000
for r in self.m.generate(texte, **options):
premier = premier or time.perf_counter() - debut
morceaux.append(np.array(r.audio, dtype=np.float32))
sr = r.sample_rate
return np.concatenate(morceaux), sr, premier
if self.type == "piper":
morceaux, premier = [], None
for c in self.m.synthesize(texte):
premier = premier or time.perf_counter() - debut
morceaux.append(c.audio_float_array)
sr = c.sample_rate
return np.concatenate(morceaux), sr, premier
if self.type == "macos":
aiff = AUDIO / "tmp.aiff"
subprocess.run(["say", "-v", self.voix, "-o", str(aiff), texte], check=True)
a, sr = sf.read(aiff, dtype="float32")
aiff.unlink()
return a, sr, time.perf_counter() - debut # say n'écrit le fichier qu'à la fin
# Ollama et Azure renvoient du WAV PCM 16 bits mono 24 kHz, en flux.
if self.type == "ollama":
requete = dict(method="POST", url="http://localhost:11434/v1/audio/speech",
json={"model": self.modele, "input": texte})
else:
ssml = (f"<speak version='1.0' xml:lang='fr-FR'><voice name='{self.voix}'>"
f"{texte.replace('&', '&').replace('<', '<')}</voice></speak>")
requete = dict(method="POST", url=f"https://{os.environ['TTS_REGION']}.tts.speech.microsoft.com/cognitiveservices/v1",
content=ssml.encode(), headers={
"Ocp-Apim-Subscription-Key": os.environ["SPEECH_KEY"], "Content-Type": "application/ssml+xml",
"X-Microsoft-OutputFormat": "riff-24khz-16bit-mono-pcm"})
octets, premier = b"", None
with httpx.stream(**requete, timeout=300) as r:
r.raise_for_status()
for morceau in r.iter_bytes():
octets += morceau
if premier is None and len(octets) > 44: # au-delà de l'en-tête WAV
premier = time.perf_counter() - debut
# La longueur annoncée par l'en-tête est provisoire en flux : on lit les données brutes.
return np.frombuffer(octets[44:], dtype=np.int16).astype(np.float32) / 32768, 24000, premier
def normaliser(texte: str) -> str:
"""Forme parlée comparable des deux côtés : nombres en lettres, symboles développés, sans ponctuation."""
t = texte.lower().replace(" ", " ").replace(" ", " ")
t = re.sub(r"(\d) (\d{3})\b", r"\1\2", t)
t = re.sub(r"(\d+) ?h ?(\d+)", r"\1 heures \2", t)
t = re.sub(r"(\d+) ?h\b", r"\1 heures", t)
t = t.replace("%", " pour cent ").replace("€", " euros ")
t = re.sub(r"(\d+),(\d+)", lambda m: f"{m.group(1)} virgule {m.group(2)}", t)
t = re.sub(r"\d+", lambda m: " " + num2words(int(m.group()), lang="fr") + " ", t)
t = re.sub(r"[^\w\s]|_", " ", t)
return " ".join(t.split())
def transcrire(chemin: Path) -> str:
with chemin.open("rb") as f:
return stt.audio.transcriptions.create(model=STT, file=f, language="fr").text
def main() -> None:
lignes = []
for nom in CHOIX:
debut = time.perf_counter()
moteur = Moteur(nom)
moteur.synthese("Échauffement.") # chargement des poids, compilation des noyaux
chargement = time.perf_counter() - debut
mx.reset_peak_memory()
for categorie, phrases in CORPUS.items():
for i, texte in enumerate(phrases):
t0 = time.perf_counter()
audio, sr, premier = moteur.synthese(texte)
generation = time.perf_counter() - t0
fichier = AUDIO / f"{nom}-{categorie}-{i}.wav"
sf.write(fichier, audio, sr, subtype="PCM_16")
transcription = transcrire(fichier)
ref, hyp = normaliser(texte), normaliser(transcription)
duree = len(audio) / sr
lignes.append({"moteur": nom, "categorie": categorie, "texte": texte, "transcription": transcription,
"wer": round(jiwer.wer(ref, hyp), 3), "cer": round(jiwer.cer(ref, hyp), 3),
"premier_son_s": round(premier, 3), "generation_s": round(generation, 3),
"audio_s": round(duree, 2), "temps_reel_x": round(duree / generation, 2)})
print(f"{nom:17} {categorie:12} WER {lignes[-1]['wer']:.2f} x{lignes[-1]['temps_reel_x']}")
if moteur.type == "mlx":
lignes[-1]["pic_memoire_go"] = round(mx.get_peak_memory() / 2**30, 1)
lignes[-1]["chargement_s"] = round(chargement, 1)
del moteur
mx.clear_cache()
fichier = ICI / "resultats.json"
anciens = [l for l in json.loads(fichier.read_text()) if l["moteur"] not in CHOIX] if fichier.exists() else []
lignes = anciens + lignes
fichier.write_text(json.dumps(lignes, ensure_ascii=False, indent=1))
rapport(lignes)
def rapport(lignes: list[dict]) -> None:
noms = list(dict.fromkeys(l["moteur"] for l in lignes))
print("\n| Moteur | WER | CER | Premier son (médiane) | × temps réel (médiane) | Pic mémoire |")
print("|---|---|---|---|---|---|")
for n in noms:
m = [l for l in lignes if l["moteur"] == n]
pic = next((l["pic_memoire_go"] for l in m if "pic_memoire_go" in l), None)
print(f"| {n} | {statistics.mean(l['wer'] for l in m):.1%} | {statistics.mean(l['cer'] for l in m):.1%} | "
f"{statistics.median(l['premier_son_s'] for l in m):.2f} s | {statistics.median(l['temps_reel_x'] for l in m):.1f} | "
f"{f'{pic} Go' if pic else '–'} |")
print("\n| Catégorie | " + " | ".join(noms) + " |")
print("|---|" + "---|" * len(noms))
for c in CORPUS:
print(f"| {c} | " + " | ".join(
f"{statistics.mean(l['wer'] for l in lignes if l['moteur'] == n and l['categorie'] == c):.0%}" for n in noms) + " |")
if __name__ == "__main__":
main()Résultats : qui lit le mieux le français ?
| Moteur | Mots mal lus (WER) | Caractères (CER) | Premier son | Vitesse | Pic mémoire |
|---|---|---|---|---|---|
| Azure Soleil (MAI-Voice-2.1-Flash) | 0,0 % | 0,0 % | 0,52 s | 7 × | cloud |
| Voix macOS « Thomas » | 0,4 % | 0,2 % | 0,49 s | 8 × | – |
| Voxtral 4B TTS (4 bits) | 0,5 % | 0,1 % | 1,18 s | 3 × | 4,1 Go |
| Fish Audio S2 Pro (8 bits) | 0,6 % | 0,2 % | 3,77 s | 1,1 × | 15,0 Go |
| Kokoro 82M | 0,6 % | 0,1 % | 0,17 s | 26 × | 2,6 Go |
| Azure Denise (neuronale) | 1,0 % | 0,7 % | 0,26 s | 13 × | cloud |
Phonon fr |
1,4 % | 0,7 % | 0,03 s | 38 × | – |
| Piper (siwis) | 3,2 % | 1,3 % | 0,08 s | 49 × | – |
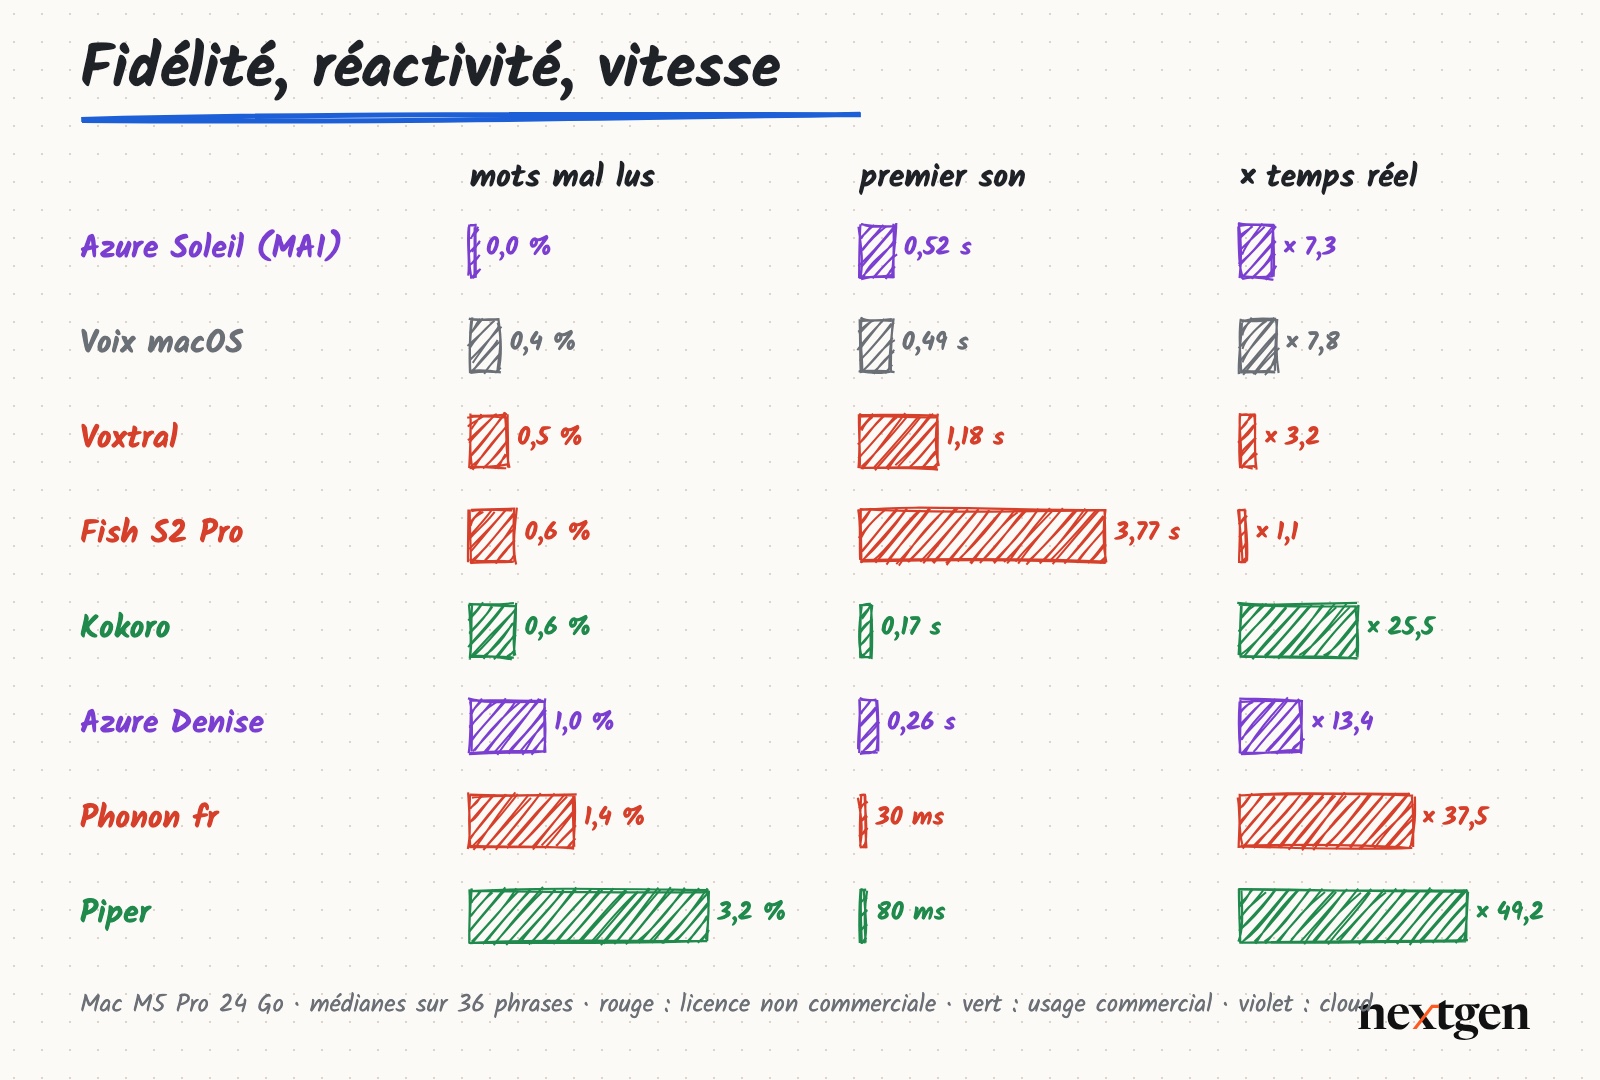
Le premier constat est que la plupart des moteurs lisent très bien le français : six sur huit restent sous 1 % de mots mal compris, et une partie des écarts restants relève de la transcription plutôt que de la voix (« KPI » transcrit « KPIs », « Nguyen » orthographié de diverses façons). La voix Soleil d’Azure, l’une des nouvelles voix MAI-Voice de Microsoft, n’a commis aucune erreur sur le corpus. Parmi les modèles exécutés en local, Voxtral, Fish S2 Pro et Kokoro font presque jeu égal sur la fidélité, entre 0,5 et 0,6 %.
Le détail par catégorie situe les faiblesses :
| Catégorie | Voxtral | Fish S2 Pro | Kokoro | Piper | Phonon | macOS | Azure Denise | Azure Soleil |
|---|---|---|---|---|---|---|---|---|
| Phrases courantes | 4 % | 0 % | 0 % | 0 % | 0 % | 0 % | 0 % | 0 % |
| Nombres | 0 % | 0 % | 0 % | 0 % | 6 % | 0 % | 5 % | 0 % |
| Dates et heures | 0 % | 0 % | 0 % | 0 % | 0 % | 0 % | 0 % | 0 % |
| Sigles | 0 % | 0 % | 0 % | 16 % | 0 % | 3 % | 0 % | 0 % |
| Anglicismes | 0 % | 0 % | 2 % | 2 % | 0 % | 0 % | 0 % | 0 % |
| Noms propres | 0 % | 4 % | 2 % | 2 % | 4 % | 0 % | 2 % | 0 % |
| Questions | 0 % | 0 % | 0 % | 3 % | 0 % | 0 % | 0 % | 0 % |
| Paragraphe long | 0 % | 0 % | 0 % | 1 % | 0 % | 0 % | 1 % | 0 % |
- Piper bute sur les sigles : « Le flux passe par un VPN puis par l’API REST de l’ERP » devient une suite de syllabes incompréhensible, « SNCF » devient « SNF ». Pour un usage informatique ou administratif, il faut épeler les sigles dans le texte (« V P N ») avant la synthèse.
- Phonon et Azure Denise trébuchent sur les nombres : Phonon lit mal les décimales (« 1 245,80 »), comme le montrait déjà notre test dédié ; Denise a lu « 37 personnes » comme « sept personnes ». Écrire les nombres en lettres avant la synthèse corrige l’essentiel de ces erreurs.
- Voxtral a commis une seule erreur, une faute d’accord (« les services informatiques a terminé »), sur une phrase pourtant banale.
Réactivité et vitesse : l’écart se creuse
C’est sur la réactivité que les moteurs se séparent nettement. Les petits modèles répondent instantanément : 30 ms avant le premier son pour Phonon, 80 ms pour Piper, 170 ms pour Kokoro. Les grands modèles sont beaucoup plus lents sur un Mac : Voxtral produit l’audio trois fois plus vite que le temps réel, et Fish S2 Pro à peine plus vite que le temps réel (1,1 ×), avec 15 Go de mémoire au pic. Sur le paragraphe long de 22 secondes, Voxtral met 6,5 secondes et Fish S2 Pro 22 secondes, contre 0,35 seconde pour Piper et 0,98 seconde pour Kokoro.
Il faut nuancer ces chiffres pour Voxtral et Fish S2 Pro : mlx-audio rend l’audio d’une phrase en une fois, si bien que le premier son n’arrive qu’à la fin de la génération. Voxtral est conçu pour le flux : Mistral annonce un premier son rapide sur GPU, avec vLLM ; sur un Mac, il convient à la production de fichiers (livres audio, messages enregistrés), moins à la conversation. Les voix d’Azure, enfin, répondent en 0,26 à 0,52 seconde, trajet réseau compris, ce qui suffit à un assistant vocal.
Écouter les voix
Deux phrases du corpus, lues par chaque moteur : l’une chargée de sigles, l’autre d’un montant décimal. Les fichiers sont ceux du banc, sans retouche.
« Le flux passe par un VPN puis par l’API REST de l’ERP. »
« Le montant de la facture s’élève à 1 245,80 euros toutes taxes comprises. »
Quelle synthèse vocale choisir ?
- Pour un produit ou un service commercial, en local : Kokoro. C’est le seul modèle testé qui associe une fidélité de premier plan (0,6 %), une forte réactivité (170 ms) et une licence Apache 2.0. Sa limite : une seule voix française.
- Pour un serveur sans GPU ou un équipement embarqué : Piper, qui tourne sur le processeur, pèse 63 Mo et génère près de cinquante fois plus vite que le temps réel, à condition d’épeler les sigles. Le moteur est sous GPL-3.0 et la voix siwis sous CC BY 4.0 : les conditions de redistribution sont à faire valider avant de l’intégrer à un logiciel distribué.
- Pour la meilleure qualité en local, hors usage commercial : Voxtral, très fidèle et présenté par Mistral comme une voix expressive, mais lent sur Mac et sous licence non commerciale. Fish S2 Pro est aussi fidèle, mais trop lent et trop gourmand sur cette machine.
- Pour un assistant conversationnel local et expérimental : Phonon, imbattable en réactivité, avec la même réserve de licence pour le français.
- Pour la fidélité maximale sans contrainte de souveraineté : Azure, et en particulier les voix MAI-Voice, sans erreur sur notre corpus, au prix d’un coût au caractère (15 dollars par million de caractères pour les voix neuronales) et d’un texte qui quitte l’entreprise.
Quel que soit le moteur, deux prétraitements simples améliorent sensiblement le résultat : écrire les nombres en lettres et épeler les sigles. Et le même protocole, appliqué à son propre vocabulaire (noms de produits, références, montants), révèle en quelques minutes les faiblesses d’une voix avant sa mise en production.
Questions fréquentes
Quelle est la meilleure synthèse vocale gratuite en français ?
Dans notre test, Kokoro est le meilleur compromis gratuit et utilisable commercialement : 0,6 % de mots mal lus, premier son en 170 ms, licence Apache 2.0. Voxtral et Fish S2 Pro sont aussi fidèles, mais leurs licences interdisent l’usage commercial sans accord et ils sont nettement plus lents sur un Mac.
Voxtral TTS fonctionne-t-il en local ?
Oui. Les poids de Voxtral 4B TTS sont publiés sur Hugging Face, et une version MLX quantifiée en 4 bits tourne sur un Mac Apple Silicon avec la bibliothèque mlx-audio, avec 4,1 Go de mémoire au pic. Elle génère environ trois fois plus vite que le temps réel. La licence CC BY-NC 4.0 limite l’usage à des fins non commerciales.
Fish Audio S2 Pro peut-il tourner sur un Mac ?
Oui, dans sa version MLX en 8 bits, mais lentement : environ 1,1 fois le temps réel et 15 Go de mémoire au pic sur un Mac M5 Pro de 24 Go. Le modèle Drama 3, plus récent, ne tient pas dans 24 Go, même en 4 bits.
Kokoro parle-t-il français ?
Oui, avec la voix ff_siwis et le code de langue f. Il a mal lu 0,6 % des mots de notre corpus, à égalité avec Fish S2 Pro. Il nécessite le phonétiseur espeak-ng.
Existe-t-il une alternative gratuite à ElevenLabs en français ?
Pour un usage local et commercial, Kokoro est l’option la plus solide de notre test ; pour un usage personnel ou de recherche, Voxtral offre une qualité supérieure. Aucun des deux n’offre le catalogue de voix ni le clonage instantané d’un service commercial, mais ils fonctionnent sans envoyer le texte à l’extérieur.
Comment mesurer objectivement la qualité d’une synthèse vocale ?
En retranscrivant l’audio avec un modèle de reconnaissance vocale et en calculant le taux d’erreur sur les mots par rapport au texte d’origine, catégorie par catégorie. Cette mesure capte l’intelligibilité ; le naturel de la voix, lui, demande une écoute humaine.