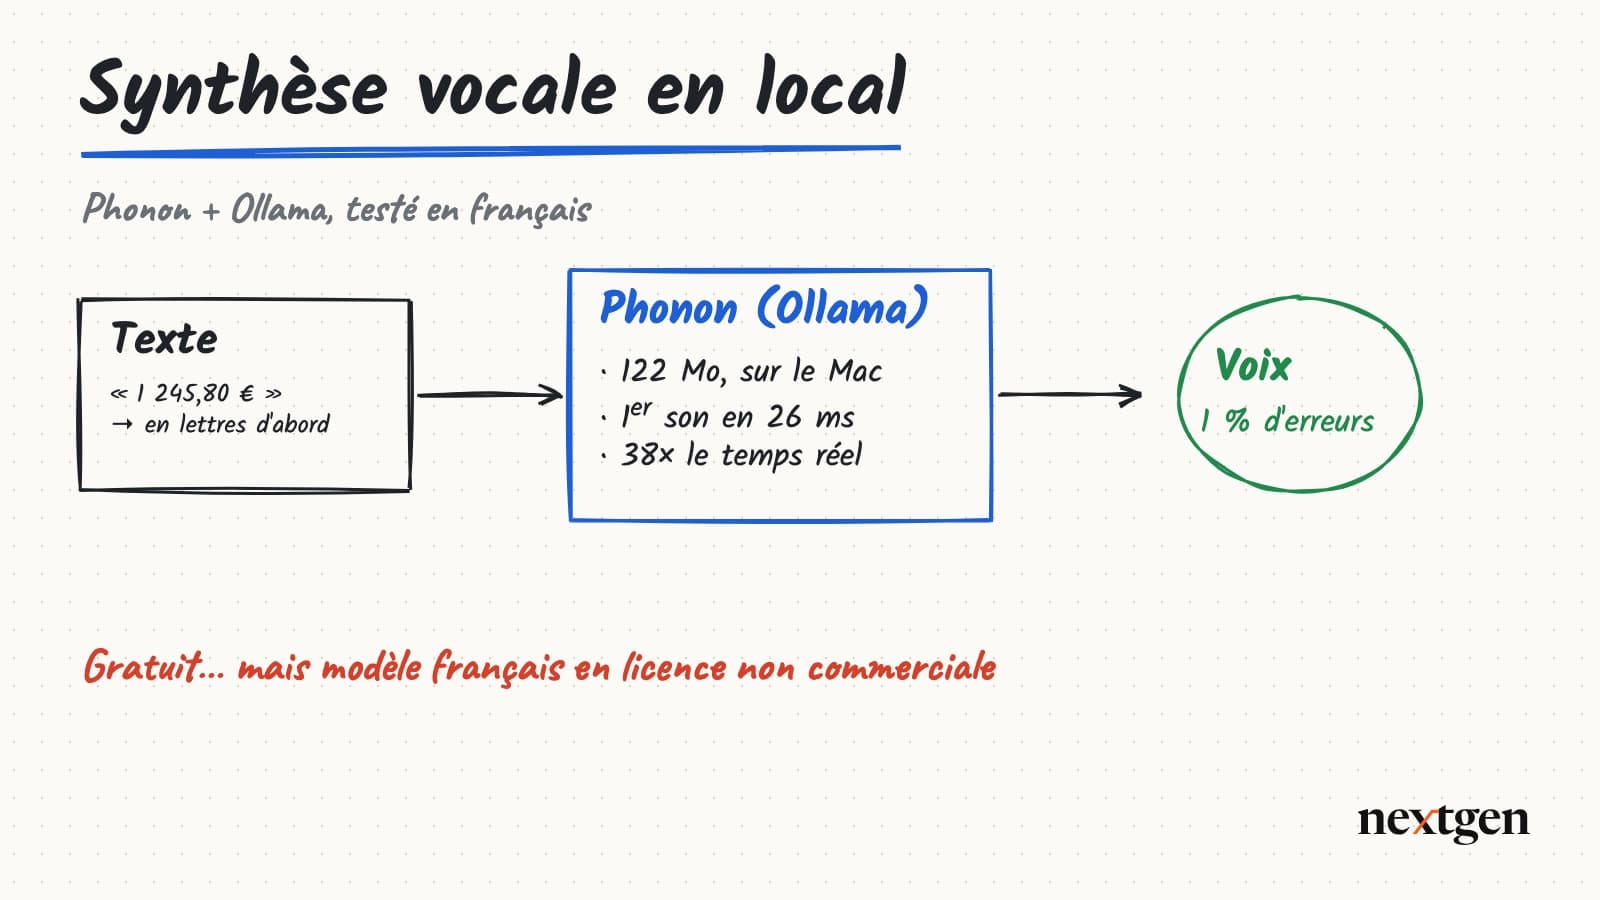
La synthèse vocale, ou text to speech, n’a longtemps eu que deux visages : les voix système, robustes mais datées, et les services en ligne, naturels mais facturés au caractère et alimentés par des textes qui quittent l’entreprise. Depuis le 24 octobre 2026, Ollama sait aussi produire de la voix, en local, avec Phonon, une famille de modèles de synthèse vocale de l’entreprise française Gradium. Les modèles pèsent environ 120 Mo, et l’un d’eux est entraîné pour le français. Nous l’avons testé sur 36 phrases choisies pour piéger une voix de synthèse : montants, dates, sigles, anglicismes, noms propres. Chaque fichier audio a ensuite été retranscrit par un modèle de reconnaissance vocale, pour mesurer objectivement ce qui a été bien lu. Nous l’avons aussi confronté aux voix neuronales d’Azure, comme référence cloud. Ce tutoriel donne le code complet, les résultats, et deux points à connaître avant tout usage professionnel : la lecture des nombres et la licence.
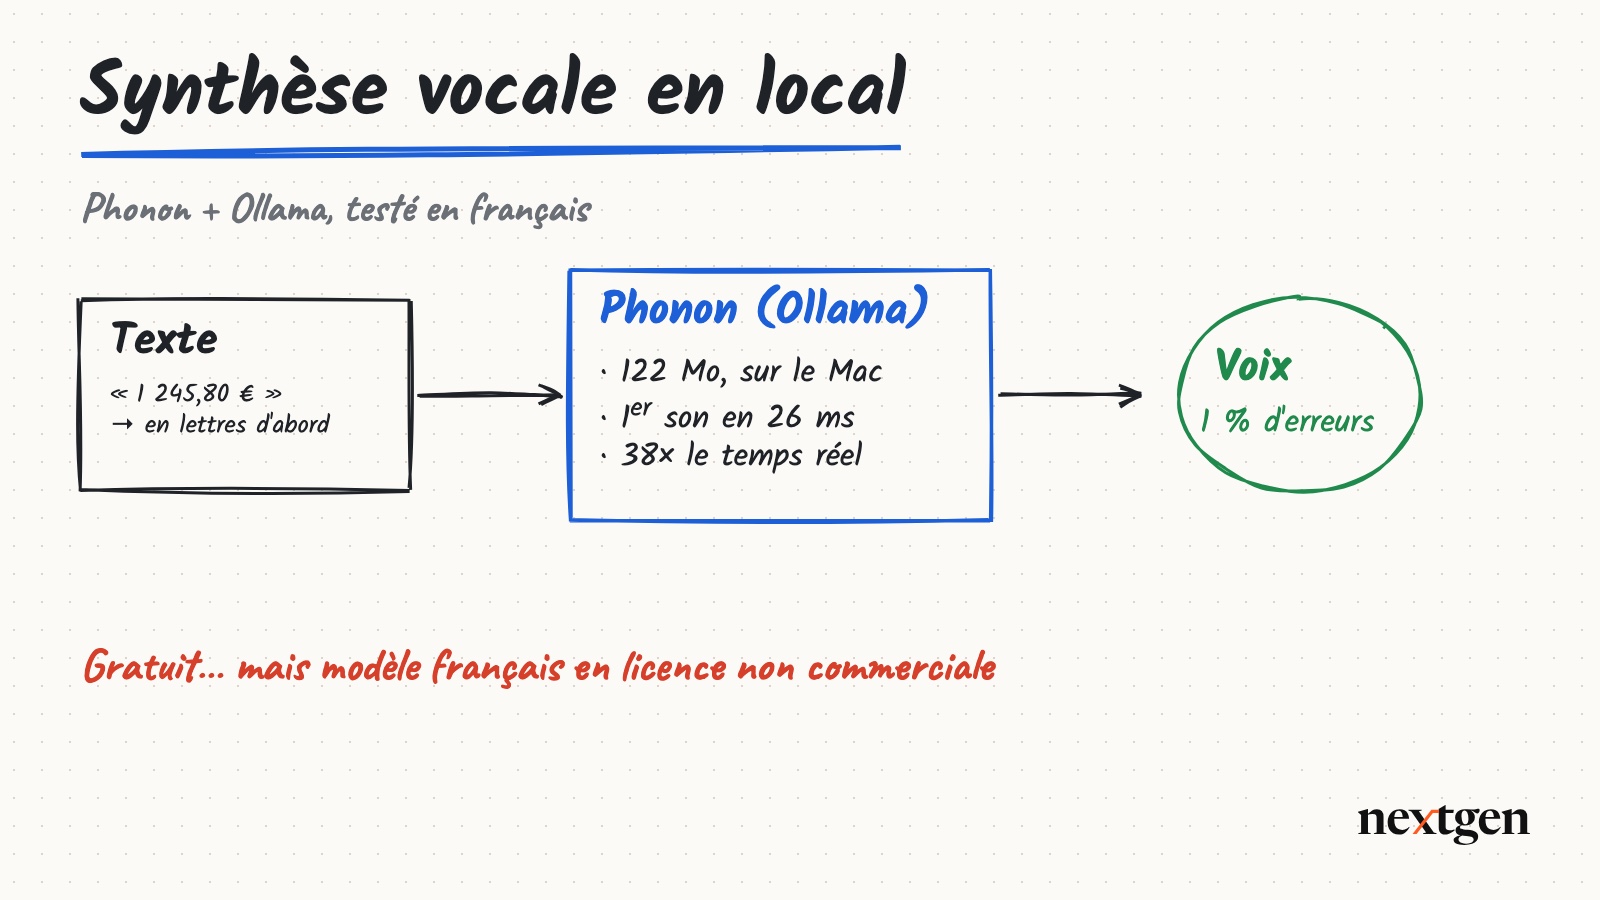
Phonon dans Ollama : ce qui change
Ollama était jusqu’ici un serveur de modèles de langage. Sa version 0.40 ajoute une capacité « speech » et l’API /v1/audio/speech, compatible avec celle d’OpenAI : un code existant qui génère de l’audio avec le SDK OpenAI n’a besoin que d’une nouvelle URL. L’audio est produit en flux, en WAV mono à 24 kHz, ce qui permet de commencer la lecture avant la fin de la génération. Sur Mac, le moteur s’appuie sur MLX ; les versions Windows et Linux sont annoncées.
La bibliothèque propose plusieurs variantes de Phonon :
phonon(ouphonon:en) : le modèle anglais, sous licence Apache 2.0, avec une trentaine de voix ;phonon:fretphonon:40m-fr: deux révisions du modèle français (environ 50 millions de paramètres), avec une seule voix ;phonon:multilingual: un modèle unique pour l’anglais, le français, l’allemand, l’espagnol et le portugais ;- des modèles dédiés à l’allemand, à l’espagnol et au portugais.
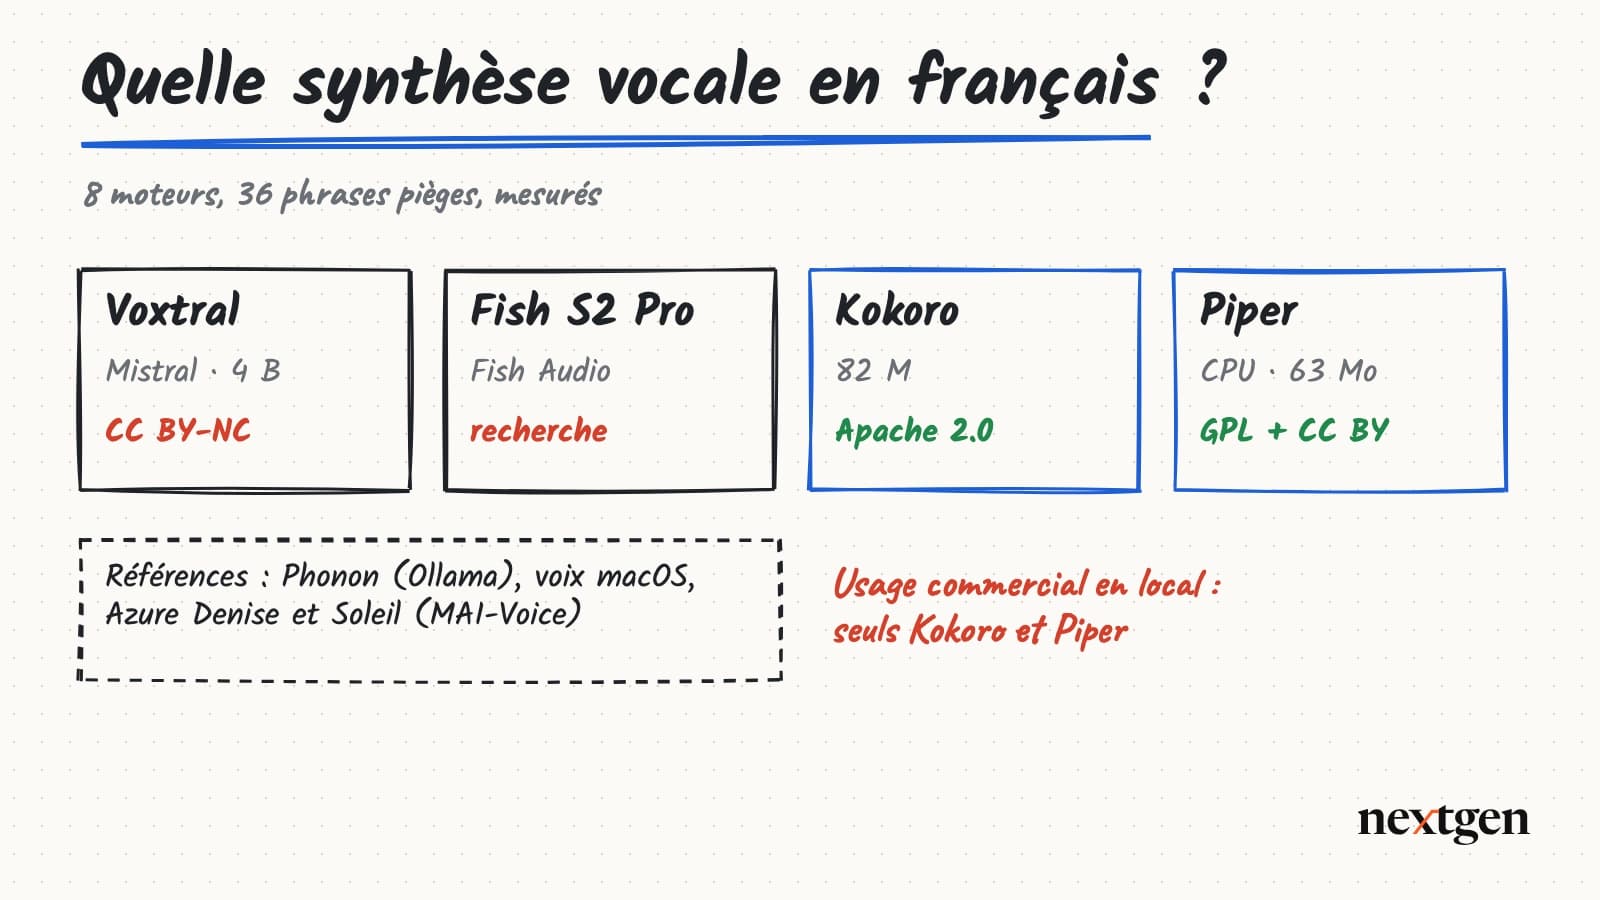
Point essentiel pour une entreprise : seuls les modèles anglais sont sous Apache 2.0. Les modèles français et multilingue sont publiés sous licence Creative Commons CC BY-NC 4.0, qui interdit l’usage commercial ; il faut alors un accord avec Gradium. La commande ollama show phonon:fr --license l’affiche explicitement.
Installer et faire parler Phonon
brew install ollama            # version 0.40.9 ou plus récente
ollama serve &
ollama pull phonon:fr          # 122 Mo

# En ligne de commande : le fichier WAV sort sur la sortie standard
ollama run phonon:fr "Bonjour, je suis une voix de synthèse locale." > bonjour.wav

# Par l'API compatible OpenAI
curl -s http://localhost:11434/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"model": "phonon:fr", "input": "Votre rendez-vous est confirmé."}' \
  --output rendez-vous.wav
Sur notre Mac, la première phrase de 4,7 secondes d’audio a été produite en 1,7 seconde, chargement du modèle compris ; les suivantes, en une fraction de seconde.
Le protocole de test
Juger une voix à l’oreille est subjectif ; nous avons préféré une mesure reproductible, l’intelligibilité. Chaque phrase est synthétisée, puis l’audio est retranscrit par un modèle de reconnaissance vocale (gpt-4o-transcribe, que nous utilisons sur notre infrastructure de test), et la transcription est comparée au texte d’origine. Le taux d’erreur sur les mots (WER) mesure alors ce qu’un auditeur, ou un système, aurait compris de travers. Avant la comparaison, les deux textes sont normalisés : nombres en lettres, ponctuation retirée, pour ne pas compter comme une erreur « 9 h 30 » transcrit « 9h30 ».
Le corpus compte 36 phrases en huit catégories : phrases courantes, nombres, dates et heures, sigles, anglicismes techniques, noms propres, questions, et un paragraphe long. Huit moteurs sont comparés : les quatre variantes de Phonon utiles ici ; la voix française « Thomas » intégrée à macOS, gratuite et disponible sans téléchargement ; et, comme référence cloud, trois voix d’Azure AI Speech : Denise, voix neuronale classique, Vivienne, voix neuronale multilingue, et Soleil, l’une des nouvelles voix MAI-Voice-2.1-Flash de Microsoft. Le banc a été exécuté sur un Mac Apple Silicon M5 Pro, avec Ollama 0.40.13.
{
  "nombres": [
    "Le montant de la facture s'élève à 1 245,80 euros toutes taxes comprises.",
    "Notre équipe compte 37 personnes réparties sur 4 sites.",
    "Le taux de disponibilité du service a atteint 99,95 % sur l'année.",
    "Vous avez 3 messages non lus et 12 tâches en attente.",
    "Le serveur dispose de 256 gigaoctets de mémoire et de 64 cœurs."
  ],
  "sigles": [
    "La DSI a validé la conformité au RGPD avant la mise en production.",
    "Le PDG présentera les résultats à l'AG des actionnaires.",
    "Le flux passe par un VPN puis par l'API REST de l'ERP.",
    "La SNCF et la RATP ont annoncé une grève pour jeudi.",
    "Votre numéro de TVA intracommunautaire figure sur le bon de commande."
  ]
}"""Synthèse vocale en français : vitesse et fidélité de Phonon (Ollama) face à la voix de macOS.
Pour chaque phrase du corpus et chaque moteur :
vitesse -> délai avant le premier échantillon audio, durée de génération, facteur de temps réel
fidélité -> l'audio est retranscrit par un modèle de reconnaissance vocale, puis comparé au texte
(taux d'erreur sur les mots, WER, et sur les caractères, CER), par catégorie
Usage :
export AOAI_ENDPOINT=… AOAI_KEY=… STT_DEPLOYMENT=gpt-4o-transcribe
python bench_tts.py
"""
import json
import os
import re
import statistics
import subprocess
import time
import wave
from pathlib import Path
import httpx
import jiwer
from num2words import num2words
from openai import AzureOpenAI
ICI = Path(__file__).parent
AUDIO = ICI / "audio"
AUDIO.mkdir(exist_ok=True)
CORPUS = json.loads((ICI / "corpus.json").read_text())
OLLAMA = "http://localhost:11434/v1/audio/speech"
MOTEURS = ["phonon:fr", "phonon:40m-fr", "phonon:multilingual", "phonon:latest", "macos:Thomas",
"azure:fr-FR-DeniseNeural", "azure:fr-FR-VivienneMultilingualNeural", "azure:fr-FR-Soleil:MAI-Voice-2.1-Flash"]
# Sous-ensemble à mesurer : MOTEURS=azure:fr-FR-DeniseNeural,… (les résultats existants sont conservés).
if os.environ.get("MOTEURS"):
MOTEURS = os.environ["MOTEURS"].split(",")
stt = AzureOpenAI(azure_endpoint=os.environ["AOAI_ENDPOINT"], api_key=os.environ["AOAI_KEY"], api_version="2025-03-01-preview")
STT = os.environ.get("STT_DEPLOYMENT", "gpt-4o-transcribe")
def duree_wav(chemin: Path) -> float:
# En flux, l'en-tête WAV ne connaît pas encore la longueur : il porte une valeur
# provisoire. On calcule donc la durée d'après la taille des données (PCM 16 bits mono).
with wave.open(str(chemin)) as w:
octets_par_seconde = w.getframerate() * w.getsampwidth() * w.getnchannels()
return (chemin.stat().st_size - 44) / octets_par_seconde
def synthese(moteur: str, texte: str, sortie: Path) -> dict:
debut = time.perf_counter()
if moteur.startswith("azure:"):
# Azure AI Speech, voix neuronales : SSML en entrée, WAV 24 kHz en flux en sortie.
voix = moteur.split(":", 1)[1]
ssml = (f"<speak version='1.0' xml:lang='fr-FR'><voice name='{voix}'>"
f"{texte.replace('&', '&').replace('<', '<')}</voice></speak>")
premier, morceaux = None, []
with httpx.stream("POST", f"https://{os.environ['TTS_REGION']}.tts.speech.microsoft.com/cognitiveservices/v1",
content=ssml.encode(), timeout=120, headers={
"Ocp-Apim-Subscription-Key": os.environ["SPEECH_KEY"],
"Content-Type": "application/ssml+xml",
"X-Microsoft-OutputFormat": "riff-24khz-16bit-mono-pcm"}) as r:
r.raise_for_status()
for morceau in r.iter_bytes():
morceaux.append(morceau)
if premier is None and sum(map(len, morceaux)) > 44:
premier = time.perf_counter() - debut
total = time.perf_counter() - debut
sortie.write_bytes(b"".join(morceaux))
elif moteur.startswith("macos:"):
aiff = sortie.with_suffix(".aiff")
subprocess.run(["say", "-v", moteur.split(":")[1], "-o", str(aiff), texte], check=True)
subprocess.run(["afconvert", "-f", "WAVE", "-d", "LEI16@24000", str(aiff), str(sortie)], check=True)
aiff.unlink()
total = time.perf_counter() - debut
premier = total # say n'écrit le fichier qu'à la fin
else:
premier, morceaux = None, []
with httpx.stream("POST", OLLAMA, json={"model": moteur, "input": texte}, timeout=300) as r:
r.raise_for_status()
for morceau in r.iter_bytes():
morceaux.append(morceau)
# L'en-tête WAV fait 44 octets : le premier son arrive avec les octets suivants.
if premier is None and sum(map(len, morceaux)) > 44:
premier = time.perf_counter() - debut
total = time.perf_counter() - debut
sortie.write_bytes(b"".join(morceaux))
audio = duree_wav(sortie)
return {"premier_son_s": round(premier, 3), "generation_s": round(total, 3), "audio_s": round(audio, 2),
"temps_reel_x": round(audio / total, 1)}
def normaliser(texte: str) -> str:
"""Forme parlée comparable des deux côtés : nombres en lettres, symboles développés, sans ponctuation."""
t = texte.lower().replace(" ", " ").replace(" ", " ")
t = re.sub(r"(\d) (\d{3})\b", r"\1\2", t) # 1 245 -> 1245
t = re.sub(r"(\d+) ?h ?(\d+)", r"\1 heures \2", t) # 9 h 30
t = re.sub(r"(\d+) ?h\b", r"\1 heures", t)
t = t.replace("%", " pour cent ").replace("€", " euros ")
t = re.sub(r"(\d+),(\d+)", lambda m: f"{m.group(1)} virgule {m.group(2)}", t)
t = re.sub(r"\d+", lambda m: " " + num2words(int(m.group()), lang="fr") + " ", t)
t = re.sub(r"[^\w\s]|_", " ", t) # ponctuation, traits d'union, apostrophes
return " ".join(t.split())
def transcrire(chemin: Path) -> str:
with chemin.open("rb") as f:
return stt.audio.transcriptions.create(model=STT, file=f, language="fr").text
def main() -> None:
lignes = []
for moteur in MOTEURS:
if not moteur.startswith("macos:"):
synthese(moteur, "Échauffement.", AUDIO / "echauffement.wav") # chargement du modèle, connexion
for categorie, phrases in CORPUS.items():
for i, texte in enumerate(phrases):
fichier = AUDIO / f"{re.sub(r'[^\w.-]', '_', moteur)}-{categorie}-{i}.wav"
mesure = synthese(moteur, texte, fichier)
transcription = transcrire(fichier)
ref, hyp = normaliser(texte), normaliser(transcription)
lignes.append({"moteur": moteur, "categorie": categorie, "texte": texte, "transcription": transcription,
"wer": round(jiwer.wer(ref, hyp), 3), "cer": round(jiwer.cer(ref, hyp), 3), **mesure})
print(f"{moteur:20} {categorie:12} WER {lignes[-1]['wer']:.2f} x{mesure['temps_reel_x']}")
fichier = ICI / "resultats.json"
anciens = [l for l in json.loads(fichier.read_text()) if l["moteur"] not in MOTEURS] if fichier.exists() else []
lignes = anciens + lignes
fichier.write_text(json.dumps(lignes, ensure_ascii=False, indent=1))
MOTEURS[:] = list(dict.fromkeys(l["moteur"] for l in lignes))
print("\n| Moteur | WER moyen | CER moyen | Premier son (médiane) | Temps réel (médiane) |")
print("|---|---|---|---|---|")
for moteur in MOTEURS:
m = [l for l in lignes if l["moteur"] == moteur]
print(f"| {moteur} | {statistics.mean(l['wer'] for l in m):.1%} | {statistics.mean(l['cer'] for l in m):.1%} | "
f"{statistics.median(l['premier_son_s'] for l in m):.2f} s | x{statistics.median(l['temps_reel_x'] for l in m)} |")
print("\nWER par catégorie :\n")
print("| Catégorie | " + " | ".join(MOTEURS) + " |")
print("|---|" + "---|" * len(MOTEURS))
for categorie in CORPUS:
print(f"| {categorie} | " + " | ".join(
f"{statistics.mean(l['wer'] for l in lignes if l['moteur'] == m and l['categorie'] == categorie):.0%}"
for m in MOTEURS) + " |")
if __name__ == "__main__":
main()Un piège rencontré en chemin : en flux, l’en-tête du fichier WAV renvoyé par Ollama ne connaît pas encore la longueur de l’audio et porte une valeur provisoire. Lire la durée dans l’en-tête donne des chiffres absurdes ; il faut la calculer d’après la taille des données, comme le fait la fonction duree_wav.
Résultats : Phonon lit le français presque sans faute
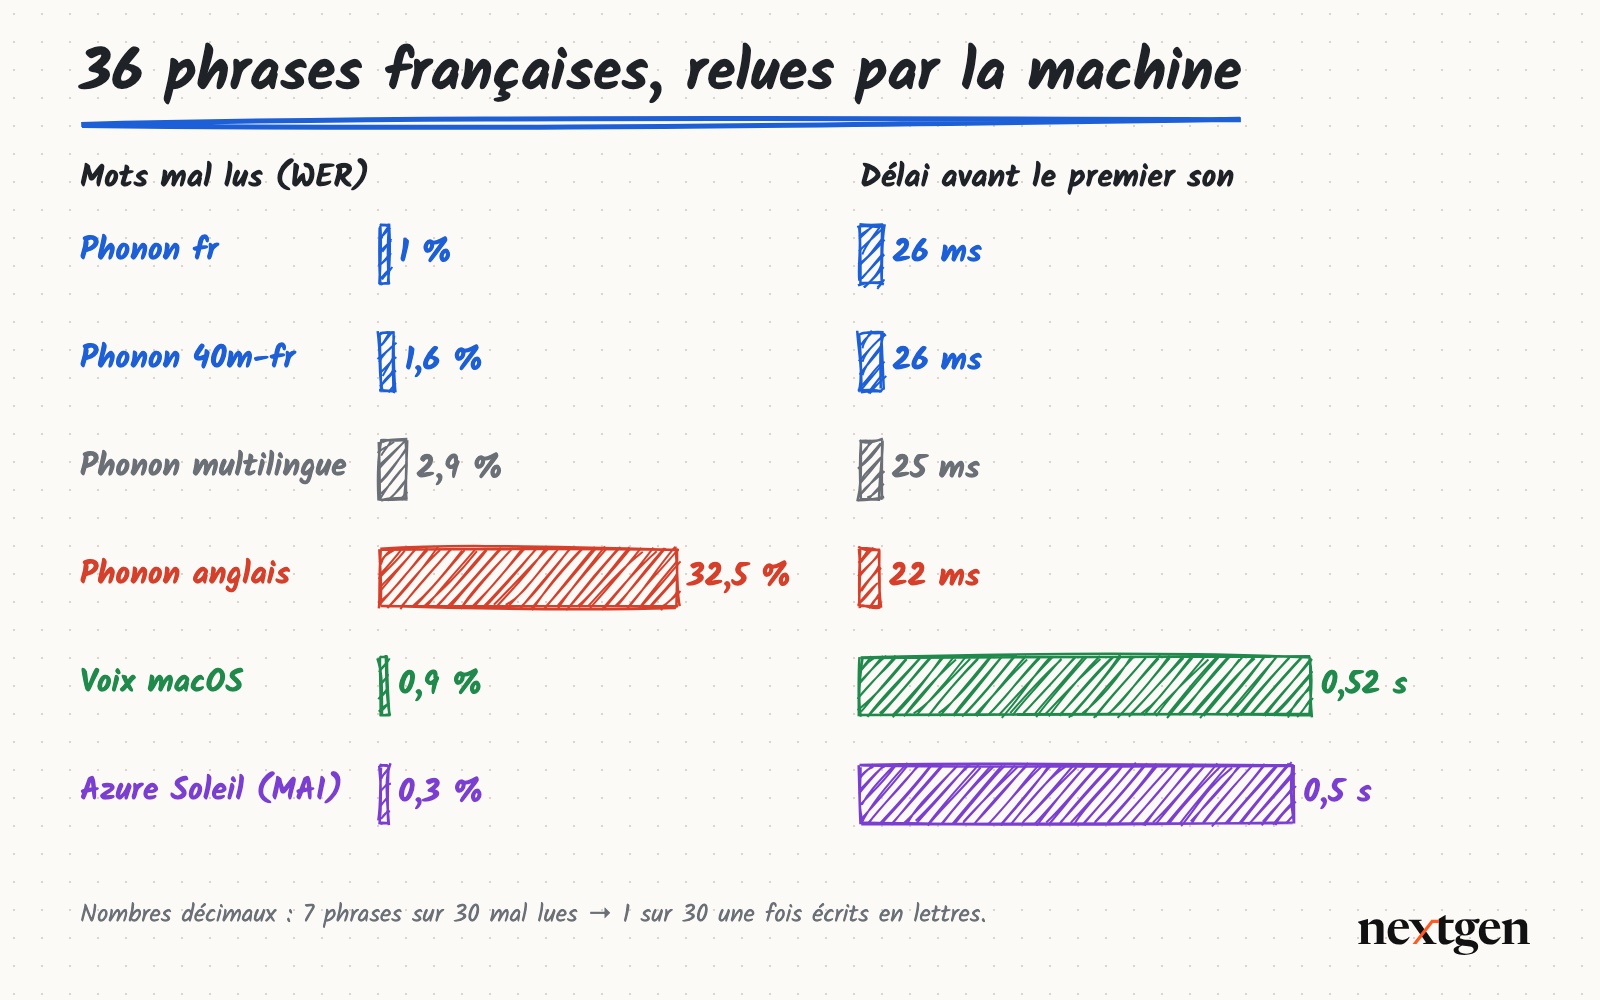
| Moteur | Mots mal lus (WER) | Caractères (CER) | Premier son | Vitesse (× temps réel) |
|---|---|---|---|---|
Phonon fr |
1,0 % | 0,6 % | 26 ms | 38 × (63 × sur un paragraphe) |
Phonon 40m-fr |
1,6 % | 1,1 % | 26 ms | 40 × |
Phonon multilingual |
2,9 % | 1,9 % | 25 ms | 39 × |
| Phonon anglais (lisant du français) | 32,5 % | 13,0 % | 22 ms | 53 × |
| Voix macOS « Thomas » | 0,9 % | 0,2 % | 0,52 s | 7 × (42 × sur un paragraphe) |
| Azure, Denise (neuronale) | 0,7 % | 0,5 % | 0,30 s | 12 × |
| Azure, Vivienne (neuronale multilingue) | 0,8 % | 0,5 % | 0,44 s | 7 × |
| Azure, Soleil (MAI-Voice-2.1-Flash) | 0,3 % | 0,1 % | 0,50 s | 8 × |
Le modèle français de Phonon atteint la même intelligibilité que la voix système de macOS, environ 1 % de mots mal compris, une partie des écarts relevant d’ailleurs de la transcription (« KPIs » au pluriel, « giga-octets » avec un trait d’union). La différence se joue ailleurs : Phonon produit le premier son en 26 millisecondes, en flux, quand la commande say de macOS n’écrit son fichier qu’à la fin, après une demi-seconde. Notre mesure porte sur l’intelligibilité, pas sur le naturel de la voix, qui reste à apprécier à l’écoute, sur ses propres textes. Le modèle anglais, lui, n’est pas une option pour le français : un tiers des mots sont mal lus.
Les voix d’Azure servent de référence cloud. Elles restent les plus fidèles : 0,3 % de mots mal lus pour la voix Soleil (MAI-Voice-2.1-Flash), 0,7 % pour Denise, et aucune difficulté sur les nombres, là où Phonon trébuche. Le premier son arrive en 0,3 à 0,5 seconde, trajet réseau compris depuis la France vers la région Europe du Nord, soit dix à vingt fois plus tard que Phonon en local ; le flux est ensuite produit sept à douze fois plus vite que le temps réel, ce qui suffit largement à une conversation. Le coût est de 15 dollars par million de caractères pour les voix neuronales en paiement à l’usage, et le texte quitte l’entreprise. L’écart de fidélité entre Phonon fr et le cloud tient presque entièrement aux nombres : une fois ceux-ci écrits en lettres (voir plus bas), il devient marginal.
Le détail par catégorie montre où se concentrent les erreurs :
| Catégorie | Phonon fr | Phonon 40m-fr | Phonon multilingue | Voix macOS | Azure Denise | Azure Soleil (MAI) |
|---|---|---|---|---|---|---|
| Phrases courantes | 0 % | 0 % | 0 % | 0 % | 0 % | 0 % |
| Nombres | 5 % | 9 % | 12 % | 0 % | 1 % | 0 % |
| Dates et heures | 0 % | 0 % | 0 % | 0 % | 0 % | 0 % |
| Sigles | 0 % | 0 % | 1 % | 3 % | 1 % | 0 % |
| Anglicismes | 2 % | 0 % | 0 % | 3 % | 0 % | 2 % |
| Noms propres | 0 % | 2 % | 4 % | 0 % | 2 % | 0 % |
| Questions | 0 % | 0 % | 3 % | 0 % | 0 % | 0 % |
| Paragraphe long | 0 % | 0 % | 0 % | 0 % | 1 % | 0 % |
Phonon lit sans difficulté les sigles (DSI, RGPD, SNCF), les dates, les heures et les termes techniques anglais, là où la voix de macOS transforme « API REST » en « appli Resf » et « DevOps » en « d’EvOps ». Sa faiblesse est ailleurs, et elle est systématique.
Le piège des nombres, et sa correction
Toutes les variantes de Phonon lisent mal les nombres décimaux et les milliers. « 1 245,80 euros » devient, selon les essais, « 1 204 580 euros » ou une suite de chiffres incohérente ; « 99,95 % » devient « 99,995 % ». Pour une facture, un relevé ou un indicateur de disponibilité, c’est rédhibitoire. La génération n’étant pas déterministe, l’erreur varie même d’un essai à l’autre sur la même phrase.
La correction est simple : écrire les nombres en lettres avant la synthèse, avec la bibliothèque num2words.
"""Écrit les nombres en lettres avant la synthèse : Phonon lit mal les décimales et les milliers.

  « 1 245,80 euros » -> « mille deux cent quarante-cinq virgule quatre-vingts euros »
  « 99,95 % »        -> « quatre-vingt-dix-neuf virgule quatre-vingt-quinze pour cent »
"""

import re

from num2words import num2words


def nombres_en_lettres(texte: str) -> str:
    t = texte.replace(" ", " ").replace(" ", " ")
    t = re.sub(r"(\d) (\d{3})\b", r"\1\2", t)                       # séparateur de milliers
    t = re.sub(r"(\d+) ?h ?(\d{2})", r"\1 heures \2", t)             # 9 h 30
    t = re.sub(r"(\d+) ?%", r"\1 pour cent", t)
    t = re.sub(r"(\d+),(\d+)", lambda m: f"{m.group(1)} virgule {m.group(2)}", t)
    return re.sub(r"\d+", lambda m: num2words(int(m.group()), lang="fr"), t)


if __name__ == "__main__":
    print(nombres_en_lettres("Le montant s'élève à 1 245,80 euros, soit 99,95 % du budget, à 9 h 30."))
Sur les dix phrases de nombres et de dates, synthétisées trois fois chacune, le nombre de phrases mal lues passe de 7 sur 30 à 1 sur 30, et le taux d’erreur moyen de 3,0 % à 0,3 %. Ce prétraitement est indispensable dès que la voix lit des montants, des quantités ou des indicateurs.
Un assistant vocal entièrement local
L’intérêt d’une synthèse rapide et en flux apparaît pleinement avec un modèle de langage : au lieu d’attendre la réponse complète, on envoie chaque phrase à Phonon dès qu’elle est terminée. Le script ci-dessous associe Qwen 3.5 9B, servi par le même Ollama, et Phonon ; rien ne quitte la machine.
"""Assistant vocal 100 % local : un LLM répond en flux, Phonon lit chaque phrase dès qu'elle est complète.

On compare le délai avant le premier son avec la méthode naïve (attendre toute la réponse).

Usage : python assistant_vocal.py "Comment sécuriser l'accès à distance de nos collaborateurs ?"
"""

import re
import sys
import time
import wave
from pathlib import Path

import httpx
from openai import OpenAI

from nombres_en_lettres import nombres_en_lettres

LLM = OpenAI(base_url="http://localhost:11434/v1", api_key="ollama")
MODELE, VOIX = "qwen3.5:9b", "phonon:fr"
FIN_DE_PHRASE = re.compile(r"(?<=[.!?…])\s+")


def dire(phrase: str) -> bytes:
    """Audio PCM d'une phrase (sans l'en-tête WAV de 44 octets)."""
    r = httpx.post("http://localhost:11434/v1/audio/speech", timeout=120,
                   json={"model": VOIX, "input": nombres_en_lettres(phrase)})
    r.raise_for_status()
    return r.content[44:]


def phrases_en_flux(question: str):
    """Rend chaque phrase de la réponse dès qu'elle est terminée."""
    flux = LLM.chat.completions.create(
        model=MODELE, stream=True, extra_body={"reasoning_effort": "none"},
        messages=[{"role": "system", "content": "Tu réponds à l'oral, en français, en quatre ou cinq phrases, sans liste ni mise en forme."},
                  {"role": "user", "content": question}])
    tampon = ""
    for e in flux:
        if e.choices and e.choices[0].delta.content:
            tampon += e.choices[0].delta.content
            *finies, tampon = FIN_DE_PHRASE.split(tampon)
            yield from (p for p in finies if p.strip())
    if tampon.strip():
        yield tampon


def main(question: str) -> None:
    debut = time.perf_counter()
    audio, premier_son, texte = [], None, []
    for phrase in phrases_en_flux(question):
        texte.append(phrase)
        audio.append(dire(phrase))
        if premier_son is None:
            premier_son = time.perf_counter() - debut  # la lecture peut commencer ici
    total = time.perf_counter() - debut
    with wave.open("audio/assistant.wav", "wb") as w:
        w.setnchannels(1), w.setsampwidth(2), w.setframerate(24000)
        w.writeframes(b"".join(audio))
    duree = sum(map(len, audio)) / 48000
    print(" ".join(texte))
    print(f"\nPremier son après {premier_son:.2f} s ; réponse complète (texte + voix) après {total:.2f} s ; "
          f"{duree:.1f} s d'audio.")
    # Méthode naïve, pour comparaison : toute la réponse d'abord, puis une seule synthèse.
    debut = time.perf_counter()
    reponse = " ".join(phrases_en_flux(question))
    dire(reponse)
    print(f"Méthode naïve : premier son après {time.perf_counter() - debut:.2f} s.")


if __name__ == "__main__":
    main(sys.argv[1] if len(sys.argv) > 1 else "Comment sécuriser l'accès à distance de nos collaborateurs ?")
Sur trois questions de DSI (accès à distance, sauvegarde et plan de reprise, migration vers le cloud), le premier son arrive entre 1,0 et 3,4 secondes après la question, contre 4,1 à 6,4 secondes en attendant la réponse complète. Le délai restant tient presque entièrement au modèle de langage, qui doit écrire sa première phrase : la synthèse elle-même ne prend que quelques dizaines de millisecondes. Raccourcir la première phrase, par la consigne système ou en découpant aussi aux virgules, réduit encore l’attente.
Ce qu’il faut retenir
- Pour le français, choisir
phonon:fr: c’est la variante la plus fidèle (1,0 % de mots mal lus), devant le modèle multilingue (2,9 %). - Écrire les nombres en lettres avant la synthèse : sans ce prétraitement, environ une phrase chiffrée sur quatre est mal lue.
- Vérifier la licence : les modèles français et multilingue sont en CC BY-NC 4.0, donc limités à un usage non commercial ; un produit ou un service client exige un accord avec Gradium. Seul le modèle anglais est sous Apache 2.0.
- Profiter du flux : avec 26 ms avant le premier son et une génération 38 à 63 fois plus rapide que le temps réel, Phonon convient à un assistant conversationnel, à condition de lui envoyer le texte phrase par phrase.
- Garder le cloud pour la fidélité maximale : les voix d’Azure, et surtout les nouvelles voix MAI-Voice, lisent sans faute les nombres et les sigles, au prix d’un délai réseau, d’un coût au caractère et d’un texte qui sort de l’entreprise.
- Mesurer plutôt qu’écouter : une transcription retour et un WER par catégorie révèlent en quelques minutes les faiblesses d’une voix sur son propre vocabulaire, montants, références ou noms de produits.
Pour l’opération inverse, la transcription de la parole en texte, voir notre test speech to text sur des appels téléphoniques. Pour servir le modèle de langage local, voir notre guide Qwen 3.5 avec Ollama, et pour choisir le serveur, LM Studio ou Ollama.
Questions fréquentes
Ollama fait-il de la synthèse vocale ?
Oui, depuis la version 0.40 (octobre 2026), avec les modèles Phonon de Gradium. La commande ollama run phonon:fr "texte" produit un fichier WAV, et l’API /v1/audio/speech, compatible OpenAI, renvoie l’audio en flux. La fonction est d’abord disponible sur macOS.
Phonon parle-t-il français ?
Oui, avec le modèle phonon:fr, qui a mal lu seulement 1 % des mots de notre corpus de 36 phrases, ou avec le modèle multilingue, un peu moins précis (2,9 %). Le modèle par défaut, anglais, ne convient pas au français : un tiers des mots sont mal lus.
Phonon est-il gratuit pour un usage professionnel ?
Le téléchargement est gratuit, mais les modèles français et multilingue sont sous licence CC BY-NC 4.0, qui exclut l’usage commercial. Un usage dans un produit ou un service facturé nécessite une licence commerciale de Gradium. Le modèle anglais est sous Apache 2.0.
Quelle est la meilleure synthèse vocale gratuite en français ?
Parmi les solutions gratuites et locales, Phonon fr et la voix intégrée de macOS ont la même intelligibilité dans notre test, environ 1 % de mots mal compris ; seules les voix payantes d’Azure font mieux (0,3 % pour Soleil, MAI-Voice-2.1-Flash). Phonon produit le premier son vingt fois plus tôt et gère mieux les termes techniques anglais ; la voix système lit mieux les nombres et n’impose aucune restriction de licence.
Phonon est-il aussi bon qu’Azure Speech ?
Presque, sur l’intelligibilité : 1,0 % de mots mal lus pour Phonon fr, contre 0,3 % à 0,8 % pour les voix d’Azure testées, l’essentiel de l’écart venant des nombres. Phonon répond en revanche dix à vingt fois plus vite (26 ms avant le premier son, contre 0,3 à 0,5 s), fonctionne sans réseau et sans coût au caractère ; Azure facture 15 dollars par million de caractères pour ses voix neuronales et n’impose pas de restriction de licence non commerciale.
Combien de mémoire faut-il pour Phonon ?
Très peu : le modèle français occupe 122 Mo sur disque. Il peut tourner à côté d’un modèle de langage sur un Mac de 16 Go sans difficulté.
Comment éviter que la voix lise mal les nombres ?
En écrivant les nombres en lettres avant la synthèse, par exemple avec la bibliothèque Python num2words : dans notre test, les phrases chiffrées mal lues sont passées de 7 sur 30 à 1 sur 30.