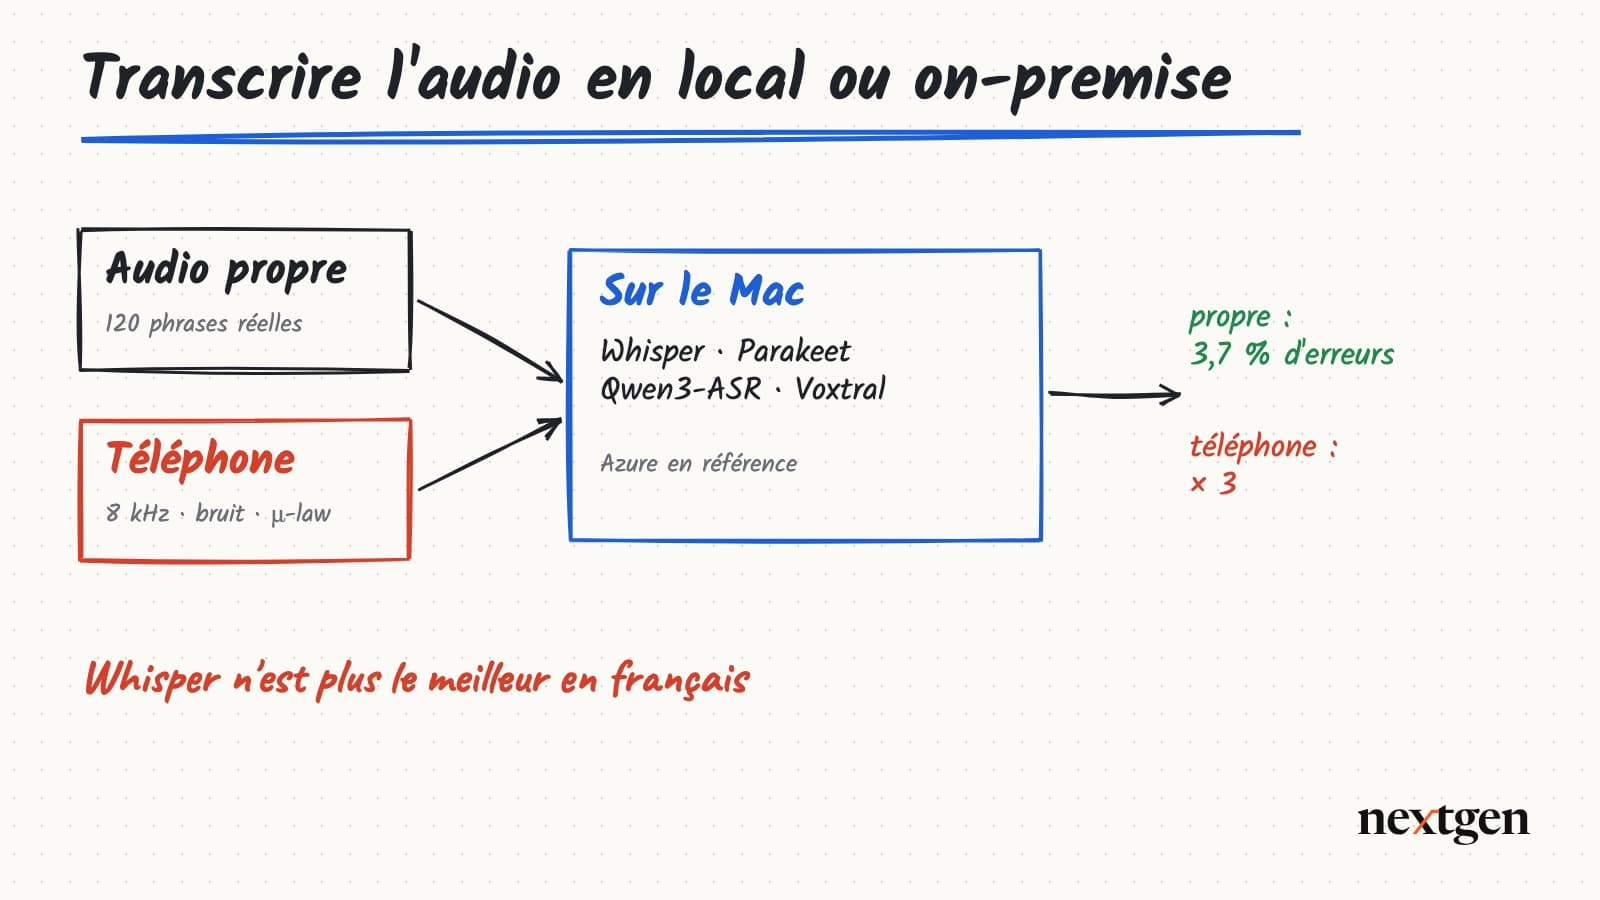
Transcrire de l’audio en texte sans envoyer les enregistrements à l’extérieur : c’est la demande de nombreuses DSI, pour les réunions, les appels du service client ou les entretiens, dès que les conversations contiennent des données personnelles ou confidentielles. Whisper, d’OpenAI, a longtemps été la seule réponse sérieuse en local ; il a désormais des concurrents ouverts : Parakeet de NVIDIA, Qwen3-ASR d’Alibaba et Voxtral de Mistral. Nous les avons comparés sur de la parole réelle, en français, lue par 120 locuteurs différents, en audio propre et en audio dégradé comme un appel téléphonique, face à deux références cloud d’Azure : gpt-4o-transcribe et MAI-Transcribe-2. Les quatre modèles locaux ont tourné sur un Mac ; les mêmes poids se déploient sur un serveur on-premise. Le code complet, les résultats et les pièges rencontrés sont détaillés ci-dessous.
Les six moteurs comparés
| Moteur | Éditeur | Taille | Licence | Exécution |
|---|---|---|---|---|
| Whisper large-v3-turbo | OpenAI | 809 millions de paramètres | MIT | local (MLX) |
| Parakeet TDT 0.6B v3 | NVIDIA | 600 millions | CC BY 4.0 | local (MLX) |
| Qwen3-ASR 1.7B (8 bits) | Alibaba (Qwen) | 1,7 milliard | Apache 2.0 | local (MLX) |
| Voxtral Mini 4B Realtime (4 bits) | Mistral AI | 4 milliards | Apache 2.0 | local (MLX) |
| gpt-4o-transcribe | OpenAI, via Azure | – | service payant | cloud |
| MAI-Transcribe-2 | Microsoft, via Azure AI Speech | – | service payant | cloud |
Les quatre modèles locaux autorisent l’usage commercial, à la différence de nombreux modèles de synthèse vocale : MIT pour Whisper, Apache 2.0 pour Qwen3-ASR et Voxtral, CC BY 4.0 (attribution) pour Parakeet.
Le protocole : de la vraie parole, et un vrai téléphone simulé
Un test de transcription n’a de valeur que sur de la parole humaine. Nous avons utilisé FLEURS, le jeu d’évaluation multilingue publié par Google sous licence CC BY 4.0, dont la partie française contient des phrases lues par des locuteurs variés, avec leur transcription de référence. Nous en avons tiré 120 phrases distinctes, soit 21 minutes d’audio.
Chaque phrase existe en deux versions : l’enregistrement d’origine, et une version « téléphone » qui reproduit une ligne téléphonique classique : bande passante limitée à 300–3 400 Hz, échantillonnage à 8 kHz, compression μ-law sur 8 bits et bruit de fond à 15 dB de rapport signal sur bruit. C’est la condition réaliste pour un centre d’appels.
"""Prépare l'échantillon de test à partir de FLEURS (français, partie test, CC BY 4.0).

Pour 120 phrases lues par de vrais locuteurs :
  propre/      -> l'enregistrement d'origine, 16 kHz
  telephone/   -> la même phrase dégradée comme un appel : bande 300-3 400 Hz, 8 kHz,
                  compression μ-law, bruit de fond à 15 dB de rapport signal sur bruit
  references.json -> la transcription humaine de chaque phrase

Usage : python preparer.py donnees/fleurs-fr-test.parquet
"""

import io
import json
import sys
from pathlib import Path

import numpy as np
import pyarrow.parquet as pq
import soundfile as sf
from scipy.signal import butter, resample_poly, sosfilt

ICI = Path(__file__).parent
N = 120
rng = np.random.default_rng(2026)


def mu_law(x: np.ndarray, mu: float = 255.0) -> np.ndarray:
    """Compression puis décompression μ-law sur 8 bits, comme sur une ligne téléphonique."""
    y = np.sign(x) * np.log1p(mu * np.abs(x)) / np.log1p(mu)
    y = np.round((y + 1) / 2 * 255) / 255 * 2 - 1
    return np.sign(y) * np.expm1(np.abs(y) * np.log1p(mu)) / mu


def telephone(x: np.ndarray, sr: int) -> np.ndarray:
    x = sosfilt(butter(4, [300, 3400], btype="bandpass", fs=sr, output="sos"), x)
    x8 = resample_poly(x, 1, sr // 8000)
    bruit = rng.normal(0, 1, len(x8))
    bruit *= np.sqrt(np.mean(x8 ** 2) / 10 ** (15 / 10)) / np.sqrt(np.mean(bruit ** 2))
    x8 = mu_law(np.clip(x8 + bruit, -1, 1))
    return resample_poly(x8, sr // 8000, 1)  # les modèles attendent du 16 kHz


def main(parquet: str) -> None:
    lignes = pq.read_table(parquet).to_pylist()
    # Une phrase par identifiant (FLEURS fait lire certaines phrases à plusieurs locuteurs).
    vues, choix = set(), []
    for l in lignes:
        if l["id"] not in vues:
            vues.add(l["id"])
            choix.append(l)
    choix = [choix[i] for i in sorted(rng.choice(len(choix), N, replace=False))]
    for d in ("propre", "telephone"):
        (ICI / d).mkdir(exist_ok=True)
    references, duree = {}, 0.0
    for l in choix:
        x, sr = sf.read(io.BytesIO(l["audio"]["bytes"]), dtype="float32")
        nom = f"{l['id']}.wav"
        sf.write(ICI / "propre" / nom, x, sr)
        sf.write(ICI / "telephone" / nom, telephone(x, sr).astype(np.float32), sr)
        references[nom] = l["raw_transcription"]
        duree += len(x) / sr
    (ICI / "references.json").write_text(json.dumps(references, ensure_ascii=False, indent=1))
    print(f"{len(references)} phrases, {duree / 60:.1f} minutes d'audio")


if __name__ == "__main__":
    main(sys.argv[1])
La mesure principale est le taux d’erreur sur les mots (WER), calculé sur l’ensemble du corpus face à la transcription humaine, après normalisation des deux textes (minuscules, nombres en lettres, ponctuation retirée). Le banc mesure aussi la vitesse, exprimée en multiple du temps réel, et le pic de mémoire des modèles locaux. Le Mac de test est un Apple Silicon M5 Pro doté de 24 Go de mémoire ; les références cloud ont été appelées depuis la France.
Installer et lancer les modèles
python3.12 -m venv .venv && source .venv/bin/activate
pip install mlx-audio==0.6.4 mlx-whisper "mistral-common" pyarrow scipy soundfile jiwer num2words openai httpx

# Jeu de test FLEURS, partie française (environ 450 Mo)
curl -L -o donnees/fleurs-fr-test.parquet \
  https://huggingface.co/api/datasets/google/fleurs/parquet/fr_fr/test/0.parquet
python preparer.py donnees/fleurs-fr-test.parquet
Whisper passe par la bibliothèque mlx-whisper : la version de mlx-audio testée refuse de le charger depuis le dépôt mlx-community/whisper-large-v3-turbo (« Processor not found »). Les trois autres modèles se chargent avec mlx-audio ; Qwen3-ASR attend la langue en toutes lettres (language="French") et Voxtral exige le paquet mistral-common.
"""Banc d'essai de transcription (speech to text) en français : modèles ouverts sur Mac et cloud.

Pour chaque phrase de l'échantillon FLEURS (voir preparer.py), en audio propre et en audio
dégradé façon téléphone :
  fidélité -> taux d'erreur sur les mots (WER) et les caractères (CER) face à la transcription humaine
  vitesse  -> durée de l'audio rapportée au temps de transcription (× temps réel)
  mémoire  -> pic de mémoire des modèles MLX

Usage :
  export AOAI_ENDPOINT=… AOAI_KEY=… SPEECH_ENDPOINT=… SPEECH_KEY=…
  python bench.py                          # tous les moteurs
  MOTEURS=whisper,parakeet python bench.py # un sous-ensemble ; les autres résultats sont conservés
"""

import json
import os
import re
import statistics
import time
from pathlib import Path

import httpx
import jiwer
import mlx.core as mx
import soundfile as sf
from num2words import num2words
from openai import AzureOpenAI

ICI = Path(__file__).parent
REFERENCES = json.loads((ICI / "references.json").read_text())
CONDITIONS = ["propre", "telephone"]
MOTEURS = {
    "whisper-turbo": "mlx-community/whisper-large-v3-turbo",
    "parakeet-v3": "mlx-community/parakeet-tdt-0.6b-v3",
    "qwen3-asr": "mlx-community/Qwen3-ASR-1.7B-8bit",
    "voxtral-realtime": "mlx-community/Voxtral-Mini-4B-Realtime-2602-4bit",
    "azure-gpt-4o-transcribe": "gpt-4o-transcribe",
    "azure-mai-transcribe-2": "MAI-Transcribe-2",
}
CHOIX = os.environ["MOTEURS"].split(",") if os.environ.get("MOTEURS") else list(MOTEURS)


class Moteur:
    def __init__(self, nom: str):
        self.nom, self.modele = nom, MOTEURS[nom]
        if nom == "whisper-turbo":
            import mlx_whisper
            self.whisper = mlx_whisper
        elif nom.startswith("azure-gpt"):
            self.client = AzureOpenAI(azure_endpoint=os.environ["AOAI_ENDPOINT"], api_key=os.environ["AOAI_KEY"],
                                      api_version="2025-03-01-preview")
        elif not nom.startswith("azure"):
            from mlx_audio.stt.utils import load_model
            self.m = load_model(self.modele)

    def transcrire(self, chemin: Path) -> str:
        if self.nom == "whisper-turbo":
            return self.whisper.transcribe(str(chemin), path_or_hf_repo=self.modele, language="fr")["text"]
        if self.nom.startswith("azure-gpt"):
            with chemin.open("rb") as f:
                return self.client.audio.transcriptions.create(model=self.modele, file=f, language="fr").text
        if self.nom.startswith("azure-mai"):
            return transcription_rapide(chemin)
        options = {"language": "French"} if self.nom == "qwen3-asr" else {}
        return self.m.generate(str(chemin), **options).text


def transcription_rapide(chemin: Path) -> str:
    """API Fast Transcription d'Azure AI Speech, avec le modèle MAI-Transcribe-2."""
    definition = {"enhancedMode": {"enabled": True, "model": "MAI-Transcribe-2"}}
    url = f"{os.environ['SPEECH_ENDPOINT']}/speechtotext/transcriptions:transcribe?api-version=2025-10-15"
    for essai in range(6):
        with chemin.open("rb") as audio:
            r = httpx.post(url, timeout=300, headers={"Ocp-Apim-Subscription-Key": os.environ["SPEECH_KEY"]},
                           files={"audio": (chemin.name, audio, "audio/wav"),
                                  "definition": (None, json.dumps(definition), "application/json")})
        if r.status_code != 429:
            break
        time.sleep(float(r.headers.get("Retry-After", 2 ** (essai + 1))))  # quota par minute
    r.raise_for_status()
    return " ".join(p["text"] for p in r.json()["combinedPhrases"])


def normaliser(texte: str) -> str:
    """Forme comparable : minuscules, nombres en lettres, sans ponctuation ni apostrophes typographiques."""
    t = texte.lower().replace("’", "'").replace(" ", " ").replace(" ", " ")
    t = re.sub(r"(\d) (\d{3})\b", r"\1\2", t)
    t = t.replace("%", " pour cent ").replace("€", " euros ")
    t = re.sub(r"(\d+),(\d+)", lambda m: f"{m.group(1)} virgule {m.group(2)}", t)
    t = re.sub(r"\d+", lambda m: " " + num2words(int(m.group()), lang="fr") + " ", t)
    t = re.sub(r"[^\w\s]|_", " ", t)
    return " ".join(t.split())


def main() -> None:
    lignes = []
    for nom in CHOIX:
        debut = time.perf_counter()
        moteur = Moteur(nom)
        moteur.transcrire(ICI / "propre" / next(iter(REFERENCES)))  # échauffement
        chargement = time.perf_counter() - debut
        mx.reset_peak_memory()
        for condition in CONDITIONS:
            for fichier, reference in REFERENCES.items():
                chemin = ICI / condition / fichier
                t0 = time.perf_counter()
                texte = moteur.transcrire(chemin)
                duree = time.perf_counter() - t0
                audio = sf.info(chemin).duration
                ref, hyp = normaliser(reference), normaliser(texte)
                lignes.append({"moteur": nom, "condition": condition, "fichier": fichier, "reference": reference,
                               "transcription": texte, "wer": round(jiwer.wer(ref, hyp), 4),
                               "cer": round(jiwer.cer(ref, hyp), 4), "audio_s": round(audio, 2),
                               "traitement_s": round(duree, 3)})
            m = [l for l in lignes if l["moteur"] == nom and l["condition"] == condition]
            print(f"{nom:24} {condition:10} WER {wer_global(m):.1%}")
        if not nom.startswith("azure"):
            lignes[-1]["pic_memoire_go"] = round(mx.get_peak_memory() / 2**30, 1)
        lignes[-1]["chargement_s"] = round(chargement, 1)
        del moteur
        mx.clear_cache()
    fichier = ICI / "resultats.json"
    anciens = [l for l in json.loads(fichier.read_text()) if l["moteur"] not in CHOIX] if fichier.exists() else []
    lignes = anciens + lignes
    fichier.write_text(json.dumps(lignes, ensure_ascii=False, indent=1))
    rapport(lignes)


def wer_global(lignes: list[dict]) -> float:
    """WER sur l'ensemble du corpus (erreurs cumulées / mots de référence), pas la moyenne des phrases."""
    refs = [normaliser(l["reference"]) for l in lignes]
    hyps = [normaliser(l["transcription"]) for l in lignes]
    return jiwer.wer(refs, hyps)


def rapport(lignes: list[dict]) -> None:
    noms = list(dict.fromkeys(l["moteur"] for l in lignes))
    print("\n| Moteur | WER propre | WER téléphone | CER propre | × temps réel | Pic mémoire |")
    print("|---|---|---|---|---|---|")
    for n in noms:
        p = [l for l in lignes if l["moteur"] == n and l["condition"] == "propre"]
        t = [l for l in lignes if l["moteur"] == n and l["condition"] == "telephone"]
        cer = jiwer.cer([normaliser(l["reference"]) for l in p], [normaliser(l["transcription"]) for l in p])
        vitesse = sum(l["audio_s"] for l in p + t) / sum(l["traitement_s"] for l in p + t)
        pic = next((l["pic_memoire_go"] for l in lignes if l["moteur"] == n and "pic_memoire_go" in l), None)
        print(f"| {n} | {wer_global(p):.1%} | {wer_global(t):.1%} | {cer:.1%} | {vitesse:.0f} × | {f'{pic} Go' if pic else '–'} |")


if __name__ == "__main__":
    main()
Résultats
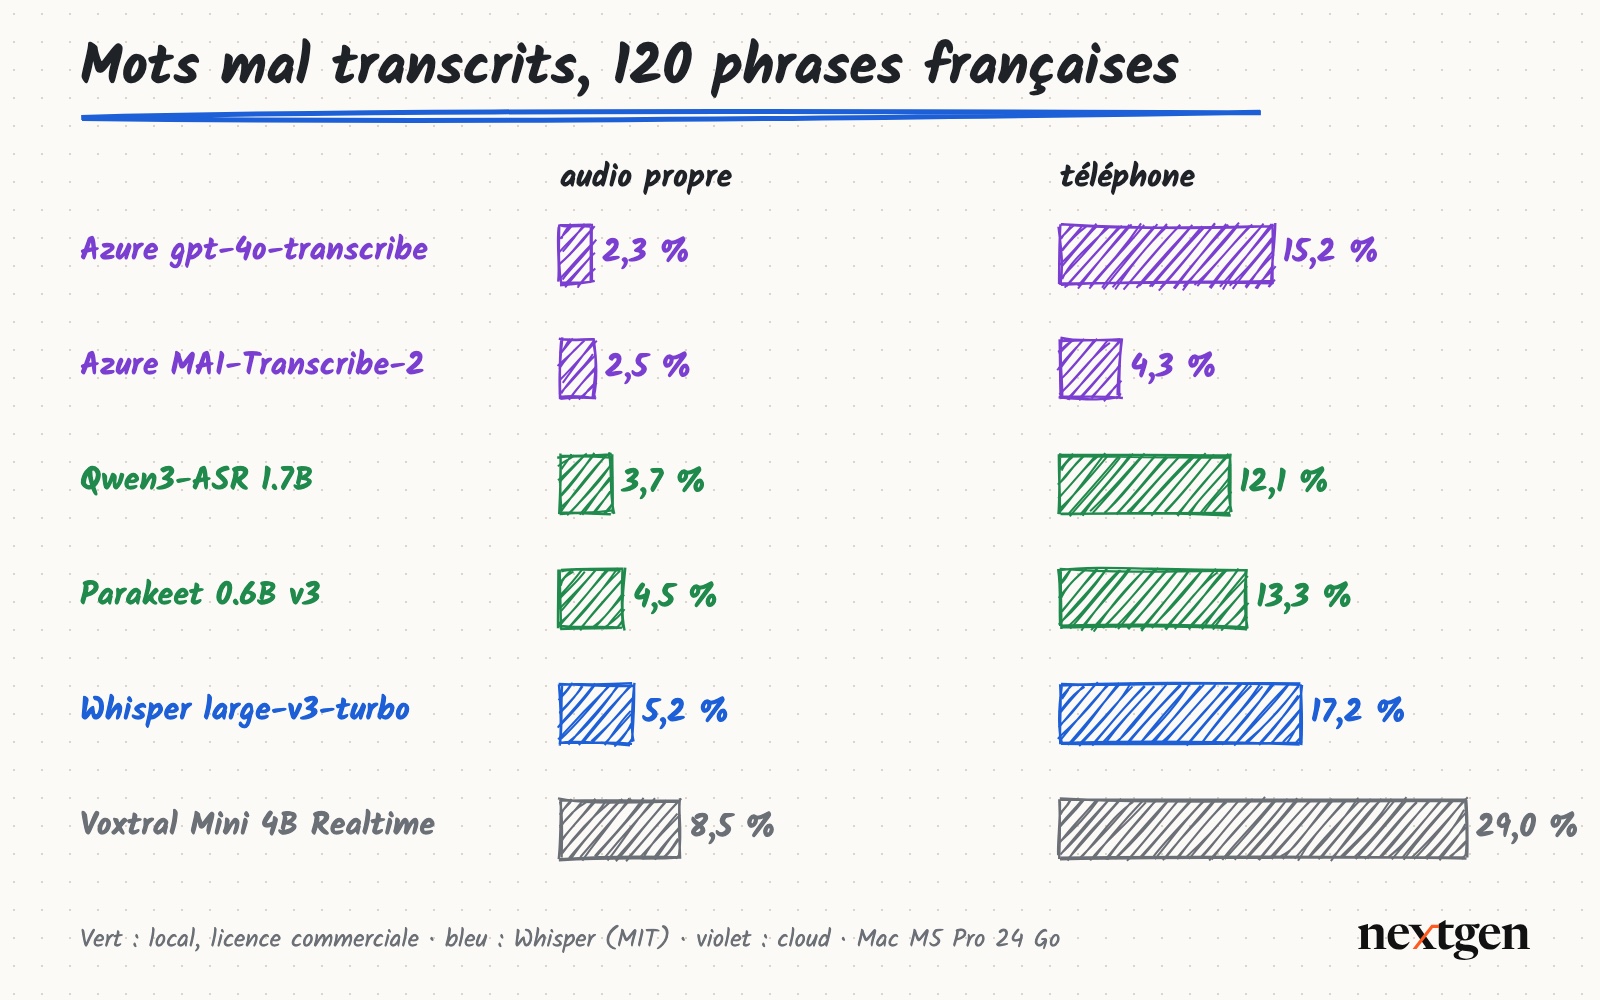
| Moteur | WER, audio propre | WER, téléphone | Phrases parfaites (propre / téléphone) | Vitesse | Pic mémoire |
|---|---|---|---|---|---|
| Azure gpt-4o-transcribe | 2,3 % | 15,2 % | 78 / 43 | 13 × | cloud |
| Azure MAI-Transcribe-2 | 2,5 % | 4,3 % | 79 / 68 | 19 × | cloud |
| Qwen3-ASR 1.7B | 3,7 % | 12,1 % | 69 / 38 | 25 × | 7,5 Go |
| Parakeet TDT 0.6B v3 | 4,5 % | 13,3 % | 53 / 27 | 143 × | 4,8 Go |
| Whisper large-v3-turbo | 5,2 % | 17,2 % | 55 / 17 | 39 × | 2,4 Go |
| Voxtral Mini 4B Realtime (4 bits) | 8,5 % | 29,0 % | 44 / 19 | 2 × | 9,4 Go |
En local, Qwen3-ASR et Parakeet devancent Whisper
Whisper n’est plus le meilleur choix local pour le français. Qwen3-ASR commet 30 % d’erreurs de moins que lui sur l’audio propre (3,7 % contre 5,2 %) et transcrit parfaitement 69 phrases sur 120, contre 55. Parakeet, un peu moins précis (4,5 %), est d’une autre catégorie en vitesse : il transcrit 143 fois plus vite que le temps réel, soit une heure d’audio en moins de 30 secondes sur un Mac, et occupe 4,8 Go. Whisper reste le plus léger en mémoire (2,4 Go).
Le téléphone change tout
Sur l’audio dégradé, les erreurs des modèles locaux triplent : 12,1 % pour Qwen3-ASR, 13,3 % pour Parakeet, 17,2 % pour Whisper, qui ne transcrit plus parfaitement que 17 phrases sur 120. La surprise vient du cloud. gpt-4o-transcribe, le plus précis sur l’audio propre, chute à 15,2 %, et ses erreurs sont d’une nature particulière : quand il entend mal, il écrit une phrase fluide et fausse. « Dans le climat chaud du Moyen-Orient, la maison n’était pas si importante » devient « Lorsque la chose lui vint en l’air, la maison était assez importante ». Pour un compte rendu d’appel, ce type d’erreur est plus dangereux qu’un mot manquant, parce qu’il ne se voit pas à la relecture. MAI-Transcribe-2, à l’inverse, résiste remarquablement : 4,3 % d’erreurs et 68 phrases parfaites sur 120, ce qui en fait, de loin, la meilleure option testée pour la voix téléphonique.
Voxtral Realtime : un modèle de flux, pas de fichiers
Voxtral Mini 4B Realtime termine dernier, mais le chiffre brut est trompeur : sur l’audio téléphonique, il a renvoyé une transcription vide pour 15 phrases sur 120. Sur les seules phrases transcrites, son taux d’erreur est de 7,1 % en audio propre et de 19,9 % au téléphone. Nous n’avons pas pu vérifier si la version 16 bits corrige ce comportement (le téléchargement du modèle a échoué) : il peut tenir à la quantification en 4 bits, au portage MLX, ou au modèle lui-même face à un audio très dégradé. Ce modèle est conçu pour la transcription en temps réel, en flux, avec une faible latence ; utilisé fichier par fichier sur un Mac, en version 4 bits, il n’est ni rapide (2 fois le temps réel) ni économe (9,4 Go). Il relève d’un serveur GPU et d’un usage en direct.
Du poste au serveur on-premise
Le test a tourné en local, sur un poste de travail. En production, les mêmes modèles se déploient sur les serveurs de l’entreprise, on-premise ou dans un cloud privé, avec deux différences. D’abord, le matériel : sur un GPU NVIDIA, Parakeet et Canary s’exécutent avec NeMo ou TensorRT, Whisper avec faster-whisper ou vLLM, Voxtral et Qwen3-ASR avec vLLM, à des débits nettement supérieurs à ceux d’un Mac. Ensuite, l’architecture : un service de transcription partagé reçoit les fichiers ou les flux, les met en file d’attente et stocke les transcriptions avec leurs droits d’accès, ce qui suppose de traiter la journalisation et la durée de conservation comme pour les enregistrements eux-mêmes.
Le choix entre on-premise et cloud se pose alors en ces termes :
- Confidentialité et souveraineté : en on-premise, l’audio ne quitte pas l’entreprise ; c’est souvent décisif pour les données de santé, les ressources humaines ou les échanges juridiques.
- Qualité sur la voix téléphonique : dans notre test, le meilleur modèle cloud (MAI-Transcribe-2) fait trois fois moins d’erreurs que le meilleur modèle local au téléphone. Pour un centre d’appels, l’écart est significatif.
- Coût : le cloud se paie à la minute d’audio ; l’on-premise se paie en matériel et en exploitation, et devient rentable avec le volume. Avec 143 fois le temps réel sur un simple Mac, Parakeet transcrit en une nuit des centaines d’heures d’archives.
- Maîtrise de la chaîne : en local, on peut adapter le vocabulaire, fine-tuner le modèle sur ses propres enregistrements et figer une version, sans dépendre des évolutions d’un service.
Lequel choisir ?
- Pour la meilleure précision en local sur un audio de bonne qualité (réunions, dictée, vidéos) : Qwen3-ASR 1.7B.
- Pour transcrire de gros volumes rapidement (archives, podcasts, lots de nuit) : Parakeet TDT 0.6B v3, quatre fois plus rapide que Whisper et plus précis.
- Pour la machine la plus modeste : Whisper large-v3-turbo, le plus léger en mémoire, et le mieux outillé.
- Pour des appels téléphoniques : MAI-Transcribe-2 sur Azure si le cloud est acceptable ; sinon Qwen3-ASR ou Parakeet, en prévoyant une relecture des passages à faible confiance.
- Dans tous les cas : mesurer sur ses propres enregistrements, avec leur qualité réelle. L’écart entre audio propre et audio téléphonique, trois fois plus d’erreurs, est plus grand que l’écart entre les modèles.
Pour la transcription d’appels avec diarisation et extraction d’informations sur Azure, voir notre test Azure LLM Speech et MAI-Transcribe-2 sur des appels. Pour l’opération inverse, la synthèse vocale, voir notre comparatif de synthèse vocale en français.
Questions fréquentes
Quel est le meilleur logiciel gratuit pour transcrire un audio en texte en français ?
Parmi les modèles ouverts testés, Qwen3-ASR 1.7B est le plus précis en français (3,7 % de mots erronés sur de la parole propre) et Parakeet TDT 0.6B v3 le plus rapide (143 fois le temps réel). Tous deux sont gratuits, exécutables en local et utilisables commercialement (Apache 2.0 et CC BY 4.0).
Whisper fonctionne-t-il en local ?
Oui. Whisper large-v3-turbo tourne en local sur un Mac avec mlx-whisper, sur un PC ou un serveur avec faster-whisper. Dans notre test, il transcrit 39 fois plus vite que le temps réel avec 2,4 Go de mémoire, mais commet plus d’erreurs que Qwen3-ASR et Parakeet en français.
Parakeet transcrit-il le français ?
Oui, depuis la version v3 (parakeet-tdt-0.6b-v3), multilingue, qui couvre 25 langues européennes. Il a commis 4,5 % d’erreurs sur notre corpus français, pour une vitesse de 143 fois le temps réel.
La transcription locale est-elle moins bonne que le cloud ?
Sur un audio propre, l’écart est faible : 3,7 % pour le meilleur modèle local contre 2,3 à 2,5 % pour le cloud. Sur un audio téléphonique, il se creuse : 12,1 % en local contre 4,3 % pour MAI-Transcribe-2, mais 15,2 % pour gpt-4o-transcribe, moins bon que les modèles locaux dans cette condition.
Peut-on déployer Whisper ou Parakeet on-premise ?
Oui. Les poids sont publiés sous licences permissives (MIT pour Whisper, CC BY 4.0 pour Parakeet) et se déploient sur des serveurs GPU avec faster-whisper, NeMo ou vLLM, l’audio ne quittant alors jamais l’infrastructure de l’entreprise.
Pourquoi la transcription d’un appel téléphonique est-elle moins bonne ?
La ligne téléphonique coupe les fréquences au-delà de 3 400 Hz, où se trouvent une partie des consonnes, échantillonne à 8 kHz et compresse le signal ; s’y ajoute souvent du bruit. Dans notre test, ces dégradations triplent le taux d’erreur des modèles locaux.