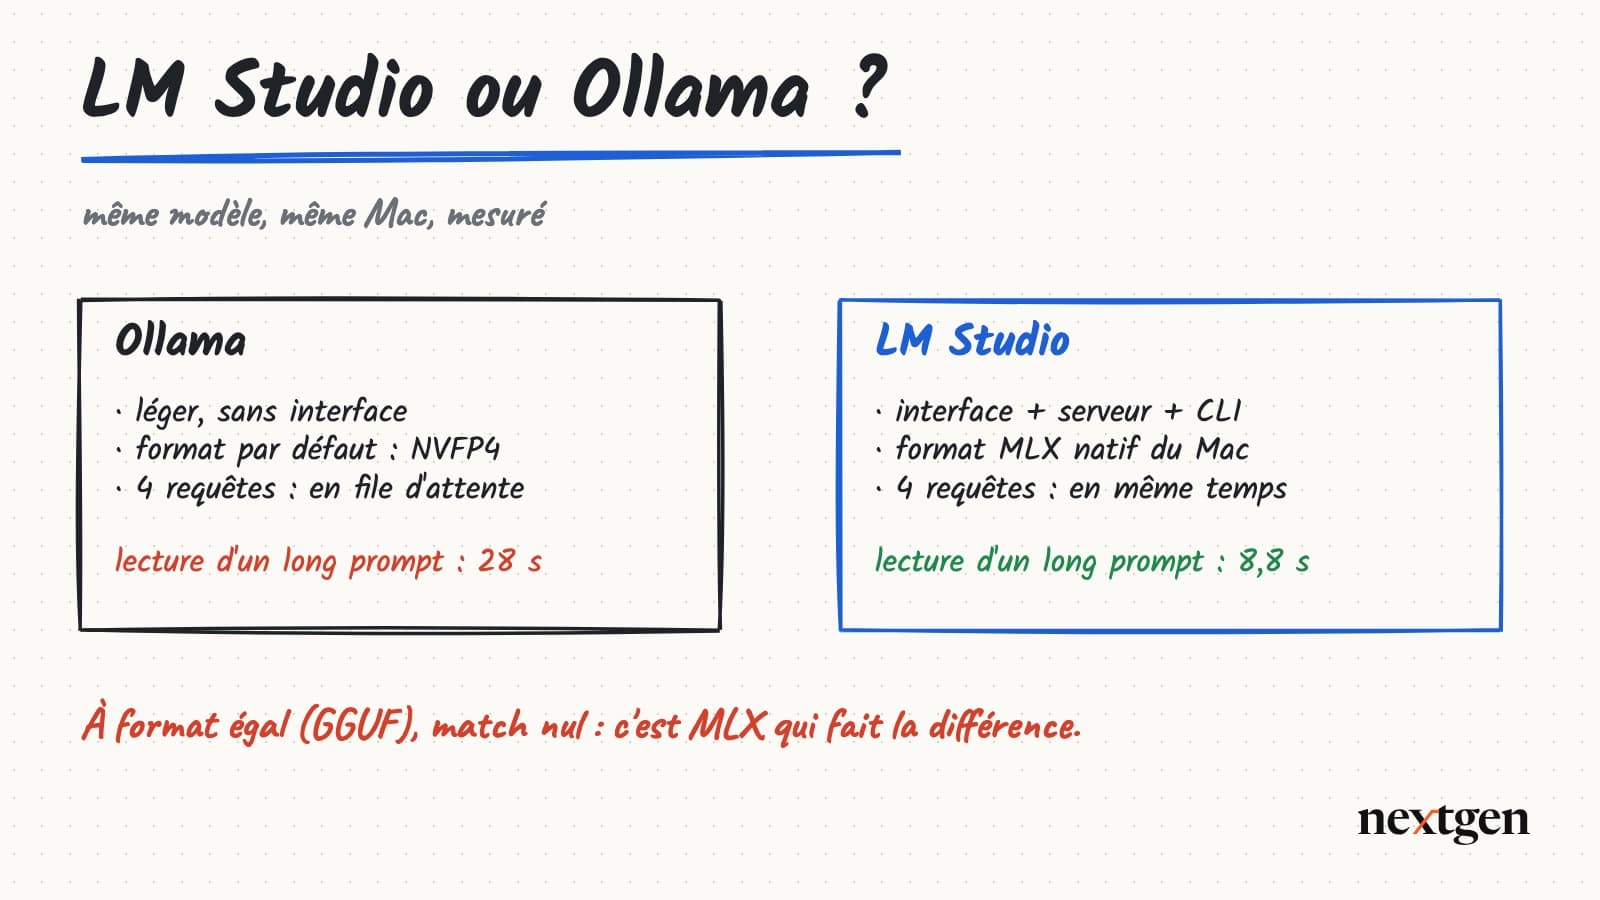
LM Studio ou Ollama ? Pour faire tourner un LLM en local sur Mac, les deux outils se sont imposés, et la question revient dès qu’une équipe veut servir un modèle ouvert sur ses propres machines : postes de développeurs, prototype d’assistant interne, traitement de documents qui ne doivent pas quitter l’entreprise. Les comparatifs disponibles opposent le plus souvent une interface graphique à une ligne de commande. Nous avons préféré mesurer : même modèle (Qwen 3.5 9B), même Mac, même script, quatre configurations, trois passages chacune. Le résultat est plus nuancé qu’un vainqueur : à format égal, les deux outils se valent ; c’est le format du modèle, et la manière de servir plusieurs requêtes à la fois, qui font l’écart.
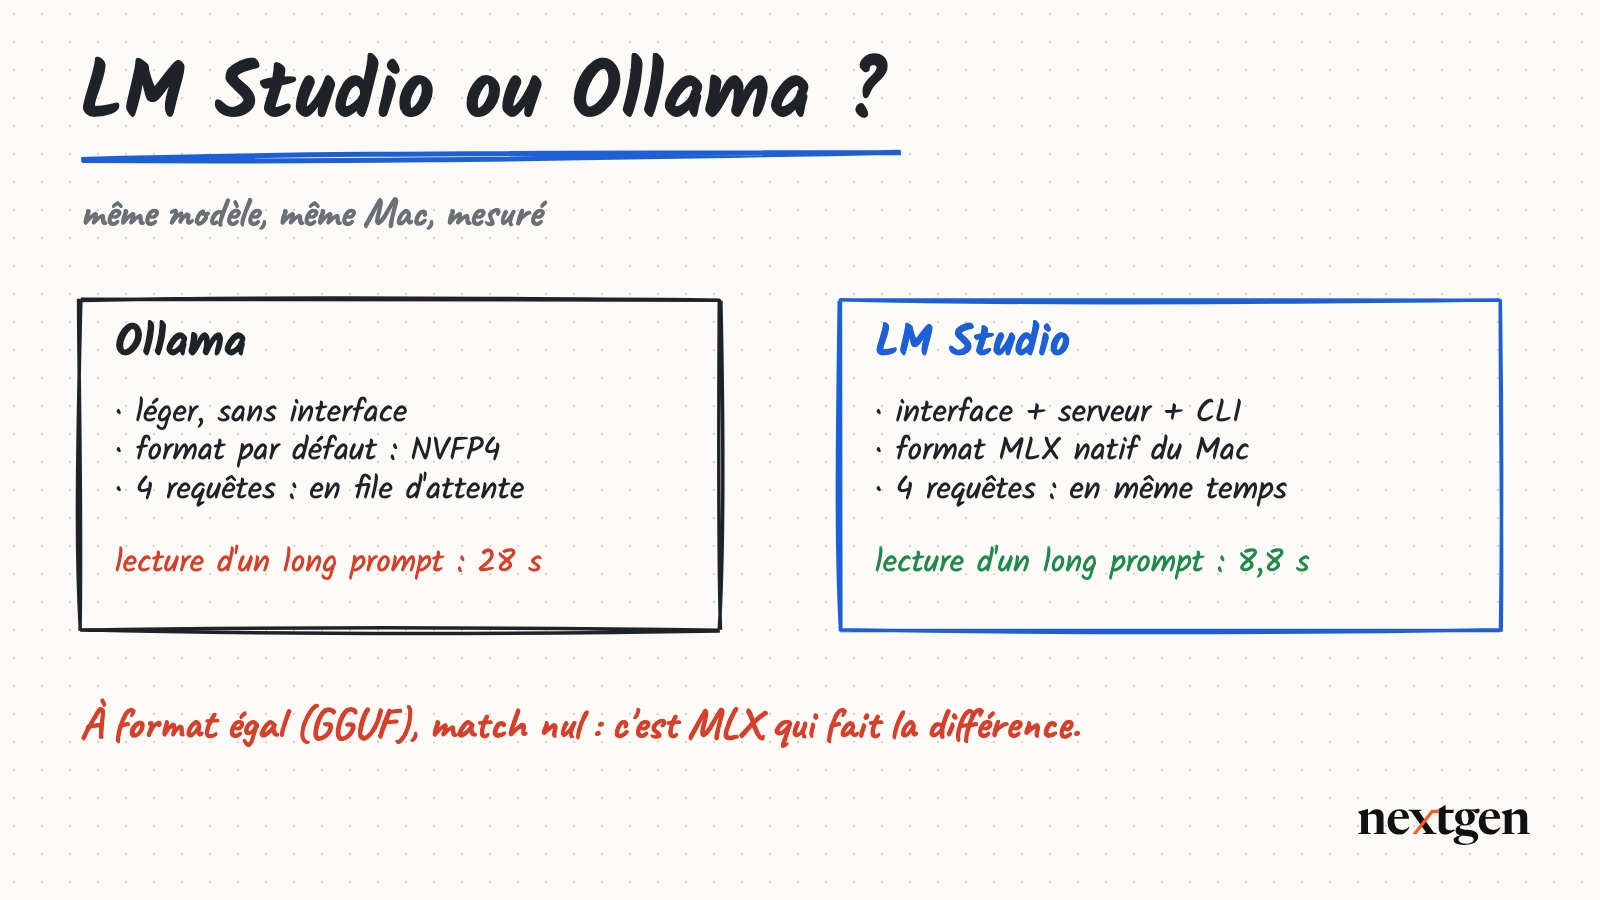
LM Studio et Ollama : deux outils, deux moteurs, trois formats
Ollama est un serveur d’inférence léger, sans interface graphique, piloté en ligne de commande et par API. Son catalogue de modèles est prêt à l’emploi (ollama pull qwen3.5:9b), et il s’installe aussi bien sur un poste que sur un serveur Linux. LM Studio est une application de bureau qui réunit une interface de conversation, un serveur d’API et une ligne de commande (lms) ; elle s’appuie sur le catalogue de Hugging Face.
Tous deux exposent une API compatible OpenAI, ce qui permet de passer de l’un à l’autre en changeant une URL. La vraie différence se situe sous le capot, dans le moteur et le format des poids :
- GGUF est le format de llama.cpp, le moteur historique des deux outils. La quantification Q4_K_M (environ 4,5 bits par poids) est la référence de fait pour un modèle de cette taille.
- MLX est le framework d’Apple pour la puce Apple Silicon. LM Studio sait l’utiliser directement, avec des poids convertis à ce format (ici en 4 bits).
- NVFP4 est un format flottant sur 4 bits. C’est celui que la bibliothèque d’Ollama 0.40 sert désormais par défaut pour
qwen3.5:9b, avec un moteur différent de llama.cpp. Ce point, peu documenté, a des conséquences mesurables, on le verra.
Nous avons donc comparé quatre configurations : Ollama avec le modèle par défaut (NVFP4), Ollama avec la variante qwen3.5:9b-q4_K_M (GGUF), LM Studio en MLX 4 bits et LM Studio en GGUF Q4_K_M.
Le protocole de test
Le banc a été exécuté sur un Mac Apple Silicon M5 Pro doté de 24 Go de mémoire unifiée, avec Ollama 0.40.13 et LM Studio 0.4.28. Le contexte est fixé à 8 192 jetons des deux côtés, la réflexion du modèle est désactivée et la température est nulle. Chaque configuration est chargée seule, après déchargement de toutes les autres, et le passage complet est répété trois fois en alternant les configurations ; nous retenons la médiane. Quatre mesures sont prises :
- la génération : débit en jetons par seconde sur des réponses d’environ 400 jetons ;
- la lecture d’un long prompt : vitesse de traitement d’un document de 7 500 jetons et attente avant le premier mot, la mesure qui compte pour l’analyse de documents ou le RAG ;
- quatre requêtes simultanées : débit cumulé, la mesure qui compte dès que plusieurs personnes ou plusieurs agents partagent le serveur ;
- les fonctions : sortie JSON contrainte par un schéma et appel d’outil.
Installer les deux outils et le modèle
brew install ollama
brew install --cask lm-studio

# Ollama : contexte de 8 192 jetons pour tous les modèles chargés
OLLAMA_CONTEXT_LENGTH=8192 ollama serve &
ollama pull qwen3.5:9b            # format par défaut (NVFP4)
ollama pull qwen3.5:9b-q4_K_M     # variante GGUF

# LM Studio : la ligne de commande lms est livrée dans l'application
LMS="/Applications/LM Studio.app/Contents/Resources/app/.webpack/lms"
open -g -a "LM Studio"            # démarre le service local
"$LMS" get qwen/qwen3.5-9b --mlx -y
"$LMS" get "qwen/qwen3.5-9b@q4_k_m" --gguf -y
"$LMS" server start               # API compatible OpenAI sur le port 1234
Premier piège : une fois les deux variantes téléchargées, LM Studio les range sous une seule clé (qwen/qwen3.5-9b, « 2 variants »), et lms load refuse la syntaxe @q4_k_m : il charge toujours la variante sélectionnée, ici MLX. Pour charger explicitement le fichier GGUF, on l’importe sous une clé distincte, par un lien physique qui ne duplique pas les 6,5 Go :
"$LMS" import ~/.lmstudio/models/lmstudio-community/Qwen3.5-9B-GGUF/Qwen3.5-9B-Q4_K_M.gguf \
  --user-repo bench/qwen3.5-9b-gguf -L -y
"$LMS" load bench/qwen3.5-9b -c 8192 --identifier qwen-gguf -y
Désactiver la réflexion de la même façon des deux côtés
Qwen 3.5 raisonne avant de répondre : sur une simple multiplication, il produit environ 500 jetons de réflexion pour une réponse de trois caractères. Pour un banc équitable, il faut couper ce raisonnement de manière identique. Le paramètre reasoning_effort: "none", passé dans le corps de la requête, fonctionne sur les deux serveurs. En revanche, chat_template_kwargs: {"enable_thinking": false}, que l’on utilise avec vLLM, est accepté par LM Studio sans erreur mais ignoré : le modèle continue de réfléchir. C’est le deuxième piège, d’autant plus sournois qu’il ne produit aucun message.
Le script de mesure
Le même script interroge les deux serveurs par l’API compatible OpenAI, en flux, ce qui permet de mesurer l’attente avant le premier jeton et le débit de génération.
"""Compare deux serveurs locaux compatibles OpenAI (Ollama, LM Studio) sur le même modèle.

Mesures, réflexion désactivée (reasoning_effort = "none") :
  generation -> débit de génération (jetons/s) et temps avant le premier jeton
  lecture    -> vitesse de lecture d'un long prompt (~6 000 jetons)
  parallele  -> 4 requêtes simultanées : débit cumulé
  fonctions  -> sortie JSON contrainte par un schéma, appel d'outil

Usage : python bench.py <nom> <base_url> <modele>
  python bench.py ollama-nvfp4 http://localhost:11434/v1 qwen3.5:9b
  python bench.py lmstudio-mlx http://localhost:1234/v1 qwen-mlx
"""

import asyncio
import json
import statistics
import sys
import time
from pathlib import Path

from openai import APIStatusError, AsyncOpenAI

NOM, BASE_URL, MODELE = sys.argv[1:4]
client = AsyncOpenAI(base_url=BASE_URL, api_key="local", timeout=600)
SANS_REFLEXION = {"reasoning_effort": "none"}
REPETITIONS = 5

SUJETS = ["la virtualisation des serveurs", "la sauvegarde 3-2-1", "le chiffrement de bout en bout",
          "les conteneurs Docker", "la haute disponibilité d'une base de données"]
# Un long document technique synthétique, identique pour les deux serveurs.
DOCUMENT = "\n".join(
    f"Incident {i} : le service {['paiement', 'stock', 'facturation', 'messagerie'][i % 4]} a été "
    f"indisponible {i % 7 + 3} minutes à cause d'un certificat expiré sur le nœud {i % 5}; "
    f"redémarrage manuel, puis renouvellement automatique activé."
    for i in range(160)
)


async def appel(messages: list[dict], max_tokens: int, **extra) -> dict:
    debut = time.perf_counter()
    premier, texte, usage = None, [], None
    flux = await client.chat.completions.create(
        model=MODELE, messages=messages, max_tokens=max_tokens, temperature=0, stream=True,
        stream_options={"include_usage": True}, extra_body=SANS_REFLEXION, **extra)
    async for e in flux:
        if e.usage:
            usage = e.usage
        if e.choices and e.choices[0].delta.content:
            premier = premier or time.perf_counter() - debut
            texte.append(e.choices[0].delta.content)
    fin = time.perf_counter() - debut
    return {"premier": premier or fin, "total": fin, "entree": usage.prompt_tokens,
            "sortie": usage.completion_tokens, "texte": "".join(texte)}


async def generation() -> dict:
    mesures = []
    for i in range(REPETITIONS):
        r = await appel([{"role": "user", "content": f"Explique {SUJETS[i]} à un DSI en 350 mots."}], 600)
        mesures.append(r)
    return {
        "premier_jeton_s": round(statistics.median(m["premier"] for m in mesures), 2),
        "jetons_par_s": round(statistics.median(m["sortie"] / (m["total"] - m["premier"]) for m in mesures), 1),
    }


async def lecture() -> dict:
    mesures = []
    for i in range(3):
        # Une question différente à chaque fois, en tête, pour éviter le cache de prompt.
        r = await appel([{"role": "user", "content": f"Question {i} : combien d'incidents concernent le service "
                          f"{['paiement', 'stock', 'facturation'][i]} ?\n\n{DOCUMENT}"}], 40)
        mesures.append(r)
    return {
        "jetons_entree": mesures[0]["entree"],
        "lecture_jetons_par_s": round(statistics.median(m["entree"] / m["premier"] for m in mesures)),
        "premier_jeton_s": round(statistics.median(m["premier"] for m in mesures), 2),
    }


async def parallele(n: int = 4) -> dict:
    debut = time.perf_counter()
    rs = await asyncio.gather(*(appel([{"role": "user", "content": f"Explique {SUJETS[i % 5]} en 300 mots."}], 500)
                                for i in range(n)))
    mur = time.perf_counter() - debut
    return {"requetes": n, "debit_cumule_jetons_par_s": round(sum(r["sortie"] for r in rs) / mur, 1),
            "duree_s": round(mur, 1)}


async def fonctions() -> dict:
    schema = {"type": "object", "additionalProperties": False, "required": ["service", "duree_minutes"],
              "properties": {"service": {"type": "string"}, "duree_minutes": {"type": "integer"}}}
    try:
        r = await client.chat.completions.create(
            model=MODELE, temperature=0, extra_body=SANS_REFLEXION,
            messages=[{"role": "user", "content": "Le service paiement a été coupé 12 minutes ce matin. Extrais les faits."}],
            response_format={"type": "json_schema", "json_schema": {"name": "incident", "strict": True, "schema": schema}})
        json_ok = json.loads(r.choices[0].message.content) == {"service": "paiement", "duree_minutes": 12}
    except (TypeError, ValueError):
        json_ok = False
    except APIStatusError as e:  # serveur ou moteur qui ne prend pas en charge la sortie structurée
        json_ok = f"erreur {e.status_code} : {e.message[:60]}"
    outil = {"type": "function", "function": {
        "name": "ouvrir_ticket", "description": "Ouvre un ticket d'incident",
        "parameters": {"type": "object", "required": ["service", "priorite"],
                       "properties": {"service": {"type": "string"}, "priorite": {"type": "string", "enum": ["P1", "P2", "P3"]}}}}}
    try:
        r = await client.chat.completions.create(
            model=MODELE, temperature=0, extra_body=SANS_REFLEXION, tools=[outil],
            messages=[{"role": "user", "content": "Le service paiement est complètement en panne, ouvre un ticket P1."}])
        appels = r.choices[0].message.tool_calls or []
        outil_ok = bool(appels) and appels[0].function.name == "ouvrir_ticket" and \
            json.loads(appels[0].function.arguments) == {"service": "paiement", "priorite": "P1"}
    except APIStatusError as e:
        outil_ok = f"erreur {e.status_code} : {e.message[:60]}"
    return {"json_schema": json_ok, "appel_outil": outil_ok}


async def main() -> None:
    await appel([{"role": "user", "content": "Bonjour"}], 5)  # échauffement : modèle chargé, noyaux compilés
    resultats = {"nom": NOM, "modele": MODELE, "generation": await generation(), "lecture": await lecture(),
                 "parallele": await parallele(), "fonctions": await fonctions()}
    Path("resultats").mkdir(exist_ok=True)
    Path(f"resultats/{NOM}.json").write_text(json.dumps(resultats, ensure_ascii=False, indent=2))
    print(json.dumps(resultats, ensure_ascii=False))


if __name__ == "__main__":
    asyncio.run(main())
Un second script charge chaque configuration à tour de rôle, mesure le temps de chargement et lance le banc :
"""Charge tour à tour chaque configuration, mesure temps de chargement et mémoire, lance bench.py.

Les deux serveurs tournent déjà : `ollama serve` (port 11434) et `lms server start` (port 1234),
avec un contexte de 8 192 jetons des deux côtés (OLLAMA_CONTEXT_LENGTH=8192, lms load -c 8192).
"""

import json
import subprocess
import sys
import time
import urllib.request

import psutil

LMS = "/Applications/LM Studio.app/Contents/Resources/app/.webpack/lms"
CONFIGS = [
    ("lmstudio-mlx", "lmstudio", "qwen/qwen3.5-9b", "qwen-mlx"),
    ("lmstudio-gguf", "lmstudio", "bench/qwen3.5-9b", "qwen-gguf"),
    ("ollama-nvfp4", "ollama", "qwen3.5:9b", "qwen3.5:9b"),
    ("ollama-gguf", "ollama", "qwen3.5:9b-q4_K_M", "qwen3.5:9b-q4_K_M"),
]


def tout_decharger() -> None:
    subprocess.run([LMS, "unload", "--all"], capture_output=True)
    for ligne in subprocess.run(["ollama", "ps"], capture_output=True, text=True).stdout.splitlines()[1:]:
        subprocess.run(["ollama", "stop", ligne.split()[0]], capture_output=True)
    time.sleep(5)


def charger(serveur: str, chemin: str, identifiant: str) -> float:
    """Durée de chargement mesurée de l'extérieur, de la même façon pour les deux serveurs."""
    debut = time.perf_counter()
    if serveur == "lmstudio":
        sortie = subprocess.run([LMS, "load", chemin, "-c", "8192", "--identifier", identifiant, "-y"],
                                capture_output=True, text=True)
        if "loaded successfully" not in sortie.stdout + sortie.stderr:
            raise RuntimeError(sortie.stderr[-500:])
    else:
        requete = urllib.request.Request("http://localhost:11434/api/generate", method="POST",
                                         data=json.dumps({"model": chemin, "keep_alive": "30m"}).encode())
        urllib.request.urlopen(requete, timeout=600).read()
    return round(time.perf_counter() - debut, 1)


def main(selection: list[str]) -> None:
    for nom, serveur, chemin, identifiant in CONFIGS:
        if selection and nom not in selection:
            continue
        tout_decharger()
        avant = psutil.virtual_memory().used
        chargement = charger(serveur, chemin, identifiant)
        url = "http://localhost:1234/v1" if serveur == "lmstudio" else "http://localhost:11434/v1"
        bench = subprocess.run([sys.executable, "bench.py", nom, url, identifiant], capture_output=True, text=True)
        memoire = (psutil.virtual_memory().used - avant) / 2**30
        if bench.returncode:
            raise RuntimeError(bench.stderr[-800:])
        resultat = json.loads(bench.stdout.strip().splitlines()[-1])
        resultat.update(chargement_s=chargement, memoire_go=round(memoire, 1))
        open(f"resultats/{nom}.json", "w").write(json.dumps(resultat, ensure_ascii=False, indent=2))
        print(json.dumps(resultat, ensure_ascii=False))
    tout_decharger()


if __name__ == "__main__":
    main(sys.argv[1:])
La mémoire demande une précaution propre au Mac : llama.cpp projette le fichier du modèle en mémoire (compté dans la mémoire résidente du processus), alors que MLX place les poids dans des allocations du GPU, que la mémoire résidente ne voit pas. Une simple lecture du moniteur d’activité sous-estime donc MLX de près de 5 Go. Nous retenons le maximum de la mémoire résidente et de l’empreinte physique du processus du moteur, mesurée après un prompt long :
"""Mémoire réelle du moteur d'inférence, après un prompt long (cache KV alloué).

Sur Mac, llama.cpp projette le fichier du modèle en mémoire (compté dans le RSS), alors que
MLX place les poids dans des allocations Metal (comptées dans l'empreinte physique, pas dans
le RSS). On retient donc le maximum des deux pour le processus du moteur.
"""

import re
import subprocess
import sys

import psutil
from openai import OpenAI

from comparer import CONFIGS, charger, tout_decharger

DOCUMENT = open("bench.py").read() * 2  # ~5 000 jetons, sous la limite de contexte de 8 192


def empreinte(pid: int) -> int:
    sortie = subprocess.run(["footprint", str(pid)], capture_output=True, text=True).stdout
    m = re.search(r"Footprint: ([\d.]+) (MB|GB)", sortie)
    return int(float(m.group(1)) * (2**20 if m.group(2) == "MB" else 2**30)) if m else 0


def moteur() -> tuple[str, float]:
    candidats = [p for p in psutil.process_iter(["pid", "name", "cmdline"])
                 if any(k in " ".join(p.info["cmdline"] or []) for k in ("llama-server", "ollama runner", ".lmstudio/.internal/utils/node"))]
    mesures = [(max(p.memory_info().rss, empreinte(p.pid)), p.info["name"]) for p in candidats]
    octets, nom = max(mesures)
    return nom, round(octets / 2**30, 1)


for nom, serveur, chemin, identifiant in CONFIGS:
    if len(sys.argv) > 1 and nom not in sys.argv[1:]:
        continue
    tout_decharger()
    charger(serveur, chemin, identifiant)
    url = "http://localhost:1234/v1" if serveur == "lmstudio" else "http://localhost:11434/v1"
    OpenAI(base_url=url, api_key="local").chat.completions.create(
        model=identifiant, max_tokens=20, extra_body={"reasoning_effort": "none"},
        messages=[{"role": "user", "content": "Résume ce code en une phrase.\n\n" + DOCUMENT}])
    processus, go = moteur()
    print(f"{nom:14} {go:5} Go  ({processus})")
tout_decharger()
Résultats : LM Studio contre Ollama, chiffres à l’appui
| Mesure (médiane de 3 passages) | Ollama NVFP4 | Ollama GGUF | LM Studio MLX | LM Studio GGUF |
|---|---|---|---|---|
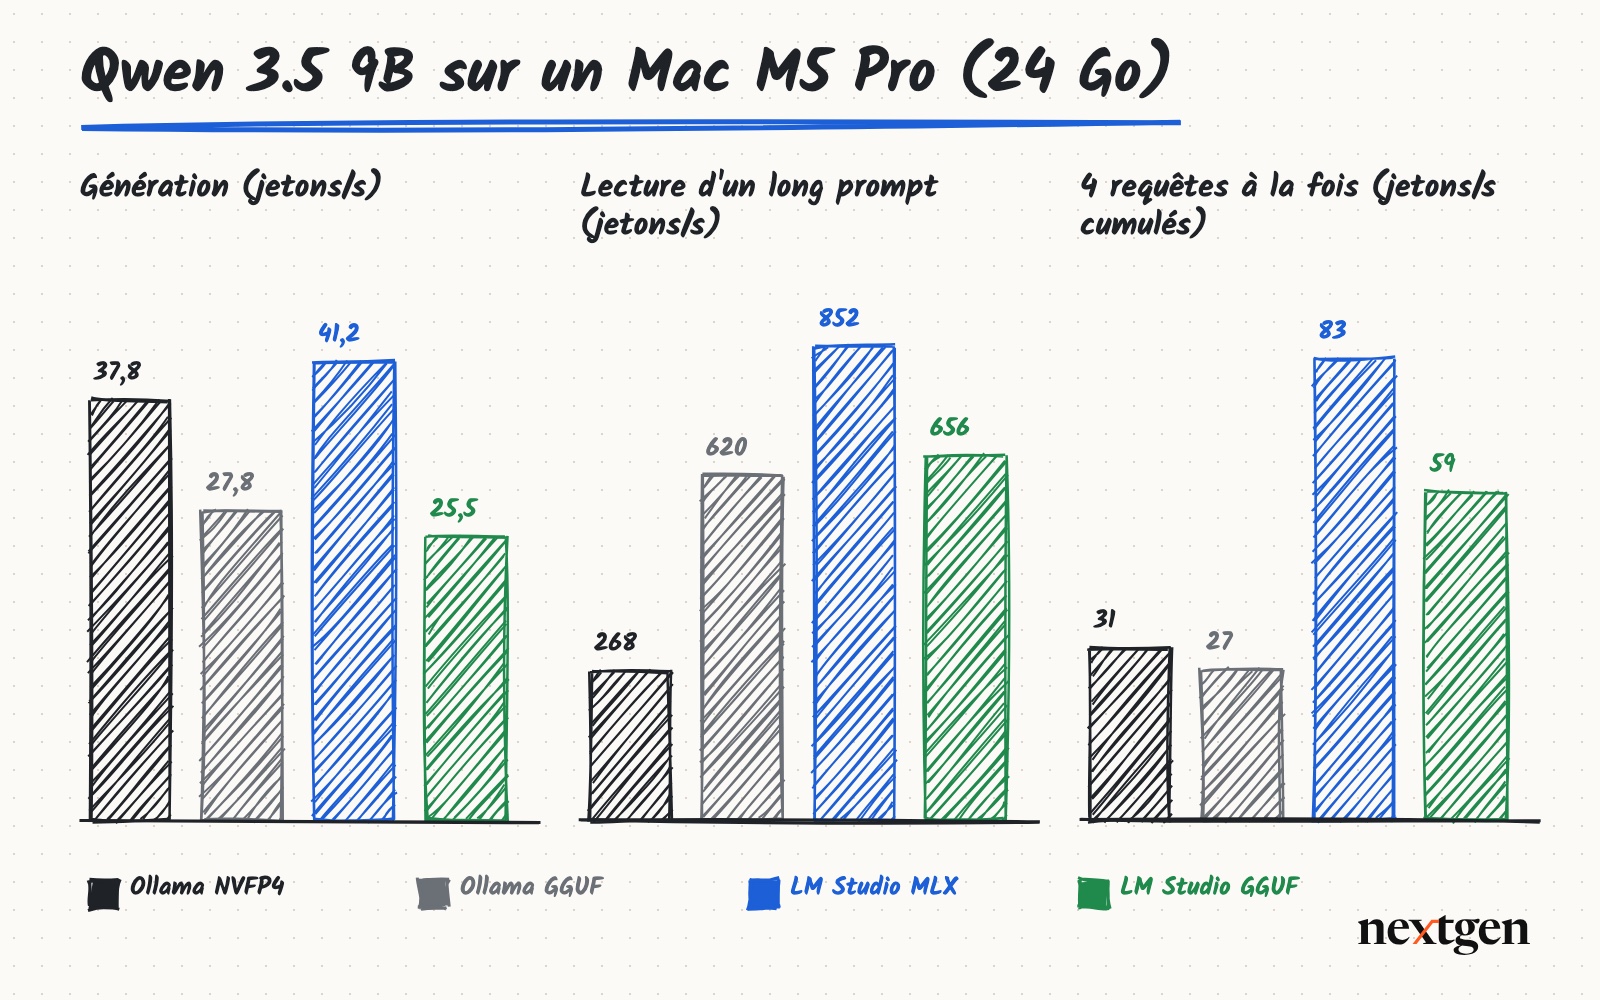
| Génération (jetons/s) | 37,8 | 27,8 | 41,2 | 25,5 |
| Premier jeton, prompt court | 0,28 s | 0,30 s | 0,30 s | 0,30 s |
| Lecture d’un prompt de 7 500 jetons (jetons/s) | 268 | 620 | 852 | 656 |
| Premier jeton, prompt de 7 500 jetons | 28,1 s | 12,1 s | 8,8 s | 11,5 s |
| 4 requêtes simultanées, débit cumulé (jetons/s) | 31 | 27 | 83 | 59 |
Idem avec OLLAMA_NUM_PARALLEL=4 |
41 | 32 | – | – |
| Chargement du modèle | 2,4 s | 2,3 s | 5,3 s | 1,7 s |
| Mémoire du moteur | 8,0 Go | 6,8 Go | 6,8 Go | 6,0 Go |
| Sortie JSON par schéma | non (erreur 501) | oui | oui | oui |
| Appel d’outil | oui | oui | oui | oui |
Les écarts entre passages sont faibles (moins de 5 % sur la plupart des mesures), à une exception près : la génération d’Ollama en NVFP4 a varié de 28,8 à 39,2 jetons par seconde d’un passage à l’autre.
À format égal, match nul
Avec le même fichier GGUF Q4_K_M, Ollama et LM Studio reposent sur le même moteur, llama.cpp, et les mesures le confirment : 27,8 contre 25,5 jetons par seconde en génération, 620 contre 656 jetons par seconde en lecture. L’écart reste dans le bruit de mesure. Choisir entre les deux outils pour une question de vitesse brute, à format identique, n’a pas de sens.
MLX fait la différence sur Mac
Le format MLX, propre à Apple Silicon, donne à LM Studio un net avantage : 41,2 jetons par seconde en génération, soit 1,6 fois le GGUF, et surtout 852 jetons par seconde en lecture. Sur un document de 7 500 jetons, le premier mot arrive après 8,8 secondes, contre 12,1 secondes en GGUF et 28,1 secondes avec le format par défaut d’Ollama. Pour un usage de type RAG ou analyse de documents, où l’essentiel du temps est passé à lire le contexte, c’est l’écart qui se ressent le plus.
Le format par défaut d’Ollama : rapide à générer, lent à lire
Le modèle NVFP4 servi par défaut par Ollama génère presque aussi vite que MLX (37,8 jetons par seconde), mais lit les longs prompts 2,3 fois plus lentement que le GGUF du même Ollama, et 3,2 fois plus lentement que LM Studio en MLX. Il occupe aussi le plus de mémoire (8,0 Go). Surtout, il refuse la sortie JSON contrainte par un schéma : l’API renvoie une erreur 501 structured output is unavailable, alors que la variante q4_K_M du même modèle la gère sans difficulté. Pour une application qui extrait des données structurées, le choix du tag n’est donc pas un détail : il faut demander explicitement qwen3.5:9b-q4_K_M.
Plusieurs requêtes à la fois : l’écart le plus net
Avec quatre requêtes simultanées, LM Studio les sert en même temps et cumule 83 jetons par seconde en MLX, deux fois son débit pour une requête seule. Ollama, dans sa configuration par défaut, les traite pour l’essentiel l’une après l’autre : le débit cumulé (27 à 31 jetons par seconde) ne dépasse pas celui d’une requête isolée. Le réglage OLLAMA_NUM_PARALLEL=4 améliore la situation sans la renverser : sur deux passages, le débit cumulé monte à 41 jetons par seconde en NVFP4 et à 32 en GGUF, soit 20 à 30 % de mieux, mais reste deux fois inférieur à celui de LM Studio en MLX. Pour un serveur partagé par une équipe ou par plusieurs agents, c’est le critère qui compte le plus.
LM Studio ou Ollama : lequel choisir ?
- Sur un Mac, pour la vitesse : LM Studio avec un modèle MLX. C’est la configuration la plus rapide sur toutes les mesures de débit, et la plus à l’aise dès que les prompts s’allongent ou que les requêtes se multiplient.
- Pour un serveur Linux, un conteneur ou une intégration continue : Ollama, plus léger, sans interface graphique, avec un catalogue prêt à l’emploi et un chargement rapide. MLX n’existe de toute façon que sur Apple Silicon.
- Pour des sorties structurées avec Ollama : choisir un tag GGUF (
q4_K_M) plutôt que le tag par défaut, et le vérifier avec un appelresponse_formatavant de bâtir l’application. - Dans tous les cas : coder contre l’API compatible OpenAI. Le même client fonctionne avec les deux serveurs, ce qui permet de changer d’outil, ou de passer à vLLM sur un serveur GPU, sans réécrire l’application.
Pour l’installation détaillée d’un modèle avec Ollama, voir nos guides Qwen 3.5 avec Ollama et Qwen, Gemma ou Granite en local sur Mac.
Questions fréquentes
LM Studio est-il plus rapide qu’Ollama ?
Sur Mac, oui, lorsqu’il utilise un modèle au format MLX : dans notre test, 41,2 jetons par seconde contre 37,8 pour Ollama en génération, et une lecture des longs prompts 3,2 fois plus rapide que le format par défaut d’Ollama. À format égal (GGUF), les deux outils sont équivalents, puisqu’ils reposent sur le même moteur, llama.cpp.
LM Studio est-il gratuit ?
Oui, LM Studio est gratuit, y compris pour un usage professionnel selon ses conditions d’utilisation actuelles ; l’application elle-même n’est pas open source, contrairement à Ollama, publié sous licence MIT.
Peut-on utiliser LM Studio comme serveur d’API ?
Oui. La commande lms server start expose une API compatible OpenAI sur le port 1234, et lms load charge un modèle sans passer par l’interface graphique. Le service local doit toutefois être démarré, par l’application ou par lms daemon up.
Pourquoi Ollama renvoie-t-il l’erreur « structured output is unavailable » ?
Parce que le modèle chargé utilise un moteur qui ne gère pas encore la sortie contrainte par un schéma, comme le tag par défaut qwen3.5:9b, au format NVFP4, dans Ollama 0.40. La variante qwen3.5:9b-q4_K_M du même modèle, au format GGUF, la prend en charge.
Combien de mémoire faut-il pour Qwen 3.5 9B en local ?
Entre 6 et 8 Go pour le moteur seul, avec un contexte de 8 192 jetons, selon le format : 6,0 Go pour LM Studio en GGUF, 6,8 Go en MLX ou pour Ollama en GGUF, 8,0 Go pour le format par défaut d’Ollama. Un Mac de 16 Go suffit donc, à condition de ne pas ouvrir un contexte beaucoup plus long.
Quelle est la différence entre GGUF et MLX ?
GGUF est le format de llama.cpp, portable sur Windows, Linux et Mac, CPU comme GPU. MLX est le framework d’Apple, optimisé pour la mémoire unifiée d’Apple Silicon et disponible uniquement sur Mac. À quantification comparable, MLX s’est montré nettement plus rapide dans notre test.