Le défi : une connaissance dispersée face à un million d’incidents par an
La disponibilité des services IT est un enjeu de résilience opérationnelle. Le client opère sa production informatique sur ServiceNow, avec un historique d’environ un million d’incidents par an. La création de valeur se joue sur la phase de diagnostic et de remédiation.
Cinq irritants freinaient la performance du run :
- Connaissance fragmentée : documentation d’exploitation, historique des résolutions et échanges en silos, difficiles à mobiliser au moment du diagnostic.
- Faible réutilisation : des incidents récurrents traités sans capitaliser sur les résolutions antérieures.
- Temps de lecture et de rédaction : des historiques longs à relire, des pièces jointes et des fils d’échanges à parcourir, un contexte à ressaisir à chaque réaffectation, des notes de résolution à rédiger à la clôture.
- Qualité de données hétérogène : descriptions et catégorisations inégales, qui limitent l’analytique et le problem management ; des problèmes récurrents qui restent invisibles.
- Demandes simples qui sollicitent les équipes alors qu’elles pourraient être traitées en libre-service.
L’ambition : industrialiser l’exploitabilité en mettant la bonne connaissance à disposition de chaque intervenant, au bon moment, dans son outil de travail.
Le choix d’une plateforme dédiée, à expérience ServiceNow native
ServiceNow propose nativement des fonctions d’IA générative pour l’ITSM. Le client a néanmoins fait le choix d’une plateforme dédiée, intégrée à son instance. Ce choix permet :
- Une intelligence nourrie par ses propres données : le moteur sémantique exploite l’historique complet des incidents et la documentation d’exploitation, au-delà de la seule base de connaissances.
- Le bon modèle pour chaque usage : les modèles de langage sont choisis par cas d’usage selon le niveau de raisonnement requis, avec une maîtrise directe des performances et des coûts d’inférence.
- Un socle unique pour treize fonctionnalités : de l’analyse automatique du nouvel incident à l’analyse de tendances, toutes partagent le même index, les mêmes garde-fous et les règles propres à la production du client.
- La maîtrise des données et de la gouvernance : hébergement, cloisonnement, habilitations et journalisation définis par le client, et non par l’éditeur.
- La complémentarité : la plateforme s’inscrit dans l’espace de travail des intervenants et peut coexister avec les fonctions natives de ServiceNow.
La solution : quatre capacités IA sur un seul socle de connaissance
La plateforme s’inscrit dans une approche d’ITSM augmenté par l’IA : elle ne remplace pas l’expertise des équipes, elle l’amplifie. Treize fonctionnalités en production, organisées en quatre capacités, couvrent tout le cycle de vie de l’incident.
Elles s’adressent à trois populations : les intervenants de production, qui diagnostiquent et résolvent ; les responsables du pilotage et du problem management, qui s’appuient sur des données fiables et sur les tendances ; les utilisateurs finaux, servis en libre-service par l’agent virtuel.
1. Résoudre plus vite grâce aux incidents similaires et à la documentation
Capacité cœur de la plateforme : dès la prise en charge, elle analyse l’incident et recommande des pistes de remédiation, sources à l’appui.
| Fonctionnalité | Ce que fait la plateforme | Ce que ça change |
|---|---|---|
| Analyse automatique du nouvel incident | Dès la prise en charge, investigation et synthèse automatiques : causes probables, enregistrements liés, points restant à vérifier. | Un diagnostic de départ au lieu d’une page blanche. |
| Proposition de résolution | Recommandations construites à partir de la base de connaissances et des incidents similaires résolus, sources citées. | Des pistes vérifiables, sans recherche manuelle. |
| Étapes de résolution suggérées | Étapes générées à partir des solutions appliquées sur des groupes d’incidents résolus comparables. | Un mode opératoire éprouvé, prêt à exécuter. |
| Incidents similaires | Les incidents comparables déjà résolus, affichés directement dans la vue de travail. | Réutilisation immédiate des résolutions passées. |
| Recherche unifiée | Une seule recherche sur la documentation, les incidents et les changements. | Fin de la navigation entre plusieurs sources. |
2. Lire et documenter l’incident en quelques secondes
La plateforme réduit le temps passé à lire et à rédiger.
| Fonctionnalité | Ce que fait la plateforme | Ce que ça change |
|---|---|---|
| Résumé d’incident | Synthèse à la demande et à chaque réaffectation, pour transmettre le contexte à l’équipe suivante. | Une prise en main en quelques secondes, sans relire l’historique. |
| Synthèse structurée | Problème, actions clés menées, résolution : un format homogène. | Une lecture identique d’un incident à l’autre. |
| Résumé des pièces jointes | Synthèse du contenu des documents et captures joints à l’incident. | Plus besoin d’ouvrir chaque pièce jointe. |
| Résumé des échanges | Synthèse des conversations et discussions liées à l’incident. | Le fil des échanges en un coup d’œil. |
| Notes de résolution | Génération des notes de résolution à la clôture, validées par l’intervenant. | Une clôture plus rapide, un historique mieux documenté. |
3. Fiabiliser la donnée dès la qualification
Des incidents bien qualifiés sont le socle du reporting, du pilotage de la performance et du problem management.
| Fonctionnalité | Ce que fait la plateforme | Ce que ça change |
|---|---|---|
| Catégorisation automatique | Proposition de la catégorie et de la sous-catégorie à partir du contenu de l’incident. | Une donnée fiable pour le reporting et l’analyse, sans effort de saisie. |
4. Détecter les tendances et réorienter vers le libre-service
Deux fonctionnalités tournées vers le pilotage et vers les utilisateurs.
| Fonctionnalité | Ce que fait la plateforme | Ce que ça change |
|---|---|---|
| Analyse de tendances | Regroupement automatique des incidents par familles, avec synthèse des récurrences. | Des problèmes de fond identifiés, candidats à la correction en amont ou à l’automatisation. |
| Agent virtuel | Assistant conversationnel pour les utilisateurs : réponses de premier niveau, création et suivi des demandes. | Réorientation des demandes simples (déflexion), équipes désengorgées. |
Un incident, pas à pas
- Prise en charge : l’incident arrive, déjà affecté. L’analyse automatique livre un premier diagnostic (causes probables, enregistrements liés, points à vérifier) ; les résumés de l’incident, des pièces jointes et des échanges donnent le contexte en quelques secondes.
- Diagnostic : les incidents similaires et les articles de la base de connaissances remontent dans la vue de travail, avec une proposition de résolution et des étapes suggérées, sources à l’appui. La recherche unifiée complète au besoin, sur la documentation, les incidents et les changements.
- Réaffectation éventuelle : la synthèse structurée (problème, actions menées, état) transmet le contexte à l’équipe suivante, sans relecture.
- Clôture : les notes de résolution sont générées puis validées par l’intervenant ; la catégorie proposée est confirmée.
- Capitalisation : l’incident résolu enrichit le socle de connaissance et alimente l’analyse de tendances, qui révèle les problèmes récurrents.
En amont de ce parcours, l’agent virtuel répond aux demandes simples des utilisateurs, crée et suit les demandes, et n’escalade vers les équipes que lorsque c’est nécessaire.
Architecture : une surcouche de ServiceNow nourrie par les données du client
La plateforme est conçue comme une surcouche de ServiceNow, pas comme un outil parallèle. Les données en entrée et les propositions en sortie restent dans l’instance, qui demeure le système de référence. L’intervenant ne change pas d’outil.
Elle repose sur une architecture de type RAG (Retrieval-Augmented Generation) : chaque recommandation est générée à partir de passages réellement retrouvés dans l’historique et la documentation du client, jamais à partir des seules connaissances générales du modèle. Cet ancrage (grounding) est ce qui rend les propositions vérifiables par les équipes.
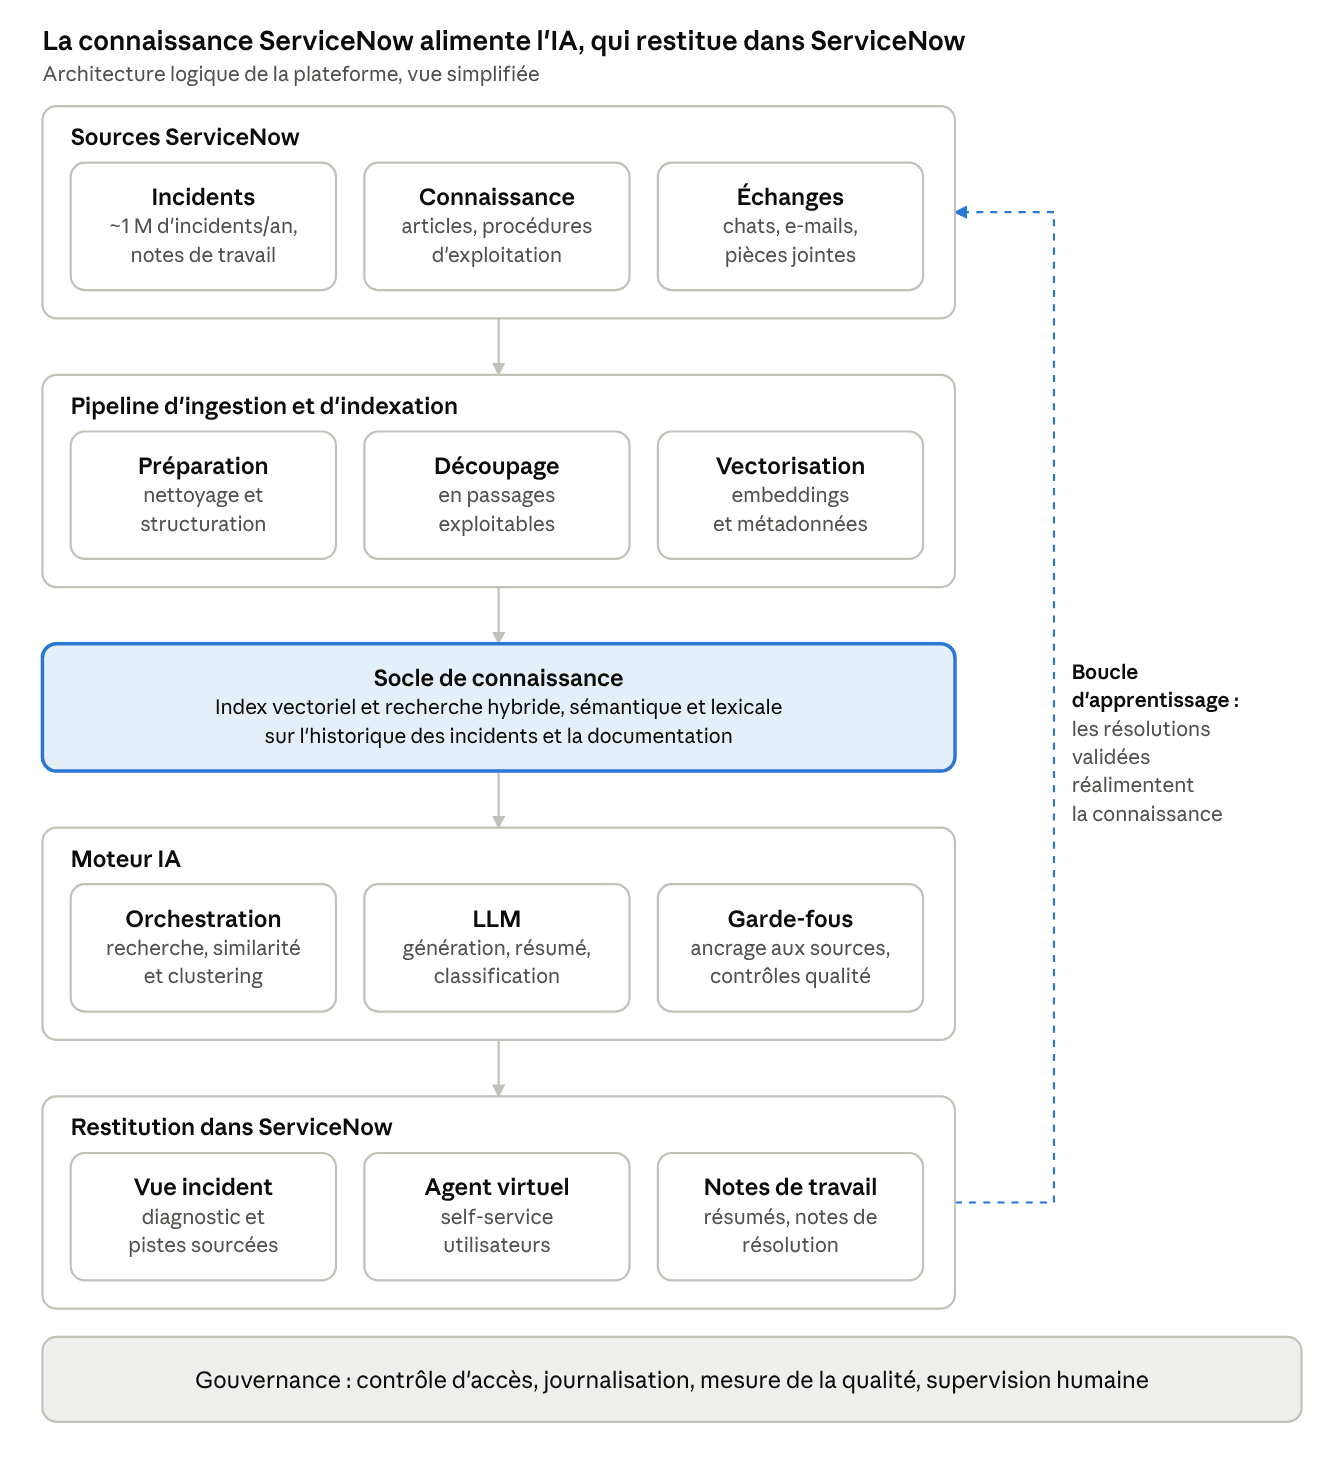
Trois principes structurent cette architecture :
- Ancrage : chaque proposition cite ses sources, l’intervenant garde la main.
- Intégration native : la valeur est délivrée dans ServiceNow, au point de décision.
- Apprentissage continu : les notes de résolution enrichissent la connaissance, dans une logique Knowledge-Centered Service.
Une trajectoire incrémentale : pilote, vagues d’extension, généralisation
La plateforme a été construite par paliers, chaque étape apportant un bénéfice mesurable avant d’élargir le périmètre.
- Cadrage et audit de la donnée : qualification de l’historique d’incidents et de la base de connaissance, identification des irritants, priorisation des cas d’usage par valeur et faisabilité.
- Pilote sur la résolution assistée : analyse automatique, incidents similaires et étapes suggérées, mis en main par un premier groupe d’intervenants, mesure de la pertinence des propositions, ajustement du moteur avec les retours terrain.
- Industrialisation : intégration dans ServiceNow, automatisation du pipeline d’indexation, mise en place de la gouvernance et de l’observabilité.
- Extension des capacités : résumés d’incident, de pièces jointes et d’échanges, notes de résolution, catégorisation, analyse de tendances et agent virtuel, en réutilisant le même socle de connaissance.
- Déploiement à l’échelle : ouverture à l’ensemble des équipes de production, accompagnement au changement et boucle d’amélioration continue.
Cette approche a permis de sécuriser l’adoption : les équipes ont vu la valeur sur leur quotidien avant que la plateforme ne s’étende à de nouveaux usages.
Gouvernance et conformité : l’humain dans la boucle, par conception
Dans les services financiers, un système d’IA appliqué à la production informatique est un système TIC comme les autres : il relève des mêmes exigences de maîtrise des risques, de documentation et de supervision que le reste du SI, dans l’esprit du règlement DORA. La plateforme a été conçue pour y répondre dès l’origine.
- Supervision humaine (human-in-the-loop) : l’IA recommande, l’intervenant décide, pour les treize fonctionnalités. Une note de résolution est relue avant la clôture, une catégorie proposée est confirmée, l’agent virtuel escalade dès qu’il sort de son périmètre.
- Traçabilité et explicabilité : chaque recommandation cite les incidents et les documents dont elle est issue ; les sollicitations et les réponses sont journalisées.
- Contrôle d’accès : la plateforme respecte les habilitations existantes ; un intervenant ne voit que ce qu’il est autorisé à voir dans ServiceNow.
- Mesure continue de la qualité : pertinence des propositions, taux d’adoption et retours des intervenants sont suivis pour piloter les évolutions.
Des bénéfices mesurés sur le terrain
Plus de 1 000 utilisateurs sollicitent régulièrement la plateforme : l’adoption à l’échelle est le premier résultat, et le plus difficile à obtenir avec l’IA générative.
- Temps moyen de résolution en baisse : l’intervenant démarre avec un diagnostic et des pistes sourcées, plutôt qu’une page blanche et une recherche manuelle dans l’historique.
- Des résolutions éprouvées remises en circulation : la proposition d’incidents similaires est au cœur de cet usage ; les solutions passées deviennent un actif réutilisable, mobilisé à chaque nouvel incident.
- Un patrimoine qui s’enrichit : résumés et notes de résolution générés puis validés améliorent la qualité de l’historique, au bénéfice des résolutions suivantes et du pilotage.
- Lecture et rédaction : résumés d’incident, de pièces jointes et d’échanges, synthèse structurée et notes de résolution réduisent le temps passé hors du diagnostic, y compris lors des réaffectations.
- Qualité de données : la catégorisation automatique fiabilise le reporting et le problem management.
- Pilotage : l’analyse de tendances rend visibles les problèmes récurrents et les candidats à une correction en amont.
- Libre-service : l’agent virtuel absorbe les demandes simples et désengorge les équipes.
Ce qui a fait la différence
- La connaissance avant le modèle : la qualité des propositions dépend d’abord de la qualité de l’historique et de la documentation. La préparation de la donnée a été traitée comme un chantier à part entière.
- Partir petit, étendre ce qui marche : une capacité, une population pilote, des retours terrain, puis des vagues d’extension sur le même socle.
- La confiance par la transparence : sources citées, validation humaine, journalisation. Les équipes adoptent ce qu’elles peuvent vérifier.
- Mesurer pour piloter : adoption, taux d’acceptation des propositions et temps de résolution sont suivis dans la durée et orientent la feuille de route.
Vers l’IA agentique
Le socle de connaissance et les garde-fous en place ouvrent la voie à de nouveaux usages : des agents capables d’exécuter des actions de remédiation sous supervision, l’extension au problem management et au change management, et l’intégration de nouvelles sources de connaissance. La trajectoire reste la même : une capacité à la fois, mesurée et validée par les équipes.