Le défi : une documentation riche, dispersée et difficile à exploiter
Dans l’industrie, la connaissance technique et scientifique est écrite, mais rarement accessible : elle est répartie entre des espaces Confluence, des bibliothèques SharePoint et des documents de formats variés, accumulés sur des années. Cinq irritants ressortaient :
- Documentation dispersée : rapports, études, procédures et comptes rendus répartis entre Confluence et SharePoint, en PDF, Word, pages wiki et scans.
- Des sujets diversifiés : des procédés aux études scientifiques, de la sécurité à la réglementation, chaque domaine avec son vocabulaire et ses acronymes.
- Une recherche par mots-clés insuffisante : un terme technique écrit autrement, un synonyme ou un acronyme suffisent à manquer le bon document.
- Du temps perdu à relire : trouver le document ne suffit pas, il faut encore y retrouver le passage utile dans des dizaines de pages.
- Une connaissance portée par quelques experts : les questions remontent toujours aux mêmes personnes, et leur départ emporte une partie de la réponse.
L’ambition : que chaque collaborateur technique ou scientifique obtienne, en langage naturel, une réponse fondée sur la documentation de l’entreprise et vérifiable à la source.
Le choix d’un assistant fondé sur les documents du client, plutôt qu’un chatbot généraliste
Un modèle de langage généraliste répond à tout, y compris de mémoire, sans garantie. Pour une documentation technique, la réponse doit venir des documents, et seulement d’eux. Cinq choix ont guidé la conception :
- L’ancrage dans les sources (RAG) : l’assistant répond uniquement à partir des passages retrouvés dans l’index et cite chaque source ; quand la documentation ne répond pas, il le dit.
- Les documents restent où ils sont : les connecteurs Confluence et SharePoint alimentent l’index automatiquement ; pas de copie manuelle, pas de seconde vérité.
- Le bon traitement pour chaque document : texte natif, pages wiki, scans passés par la reconnaissance de caractères, découpage en passages, métadonnées de sujet et de date.
- La recherche hybride : mots-clés et sens combinés, puis reclassement sémantique, pour retrouver un passage par ce qu’il dit, pas seulement par les mots employés.
- Les droits d’accès respectés : un utilisateur n’obtient de réponses qu’à partir des documents qu’il est autorisé à lire.
La solution : quatre capacités sur un seul index documentaire
L’assistant s’inscrit dans une approche de documentation augmentée par l’IA : il ne remplace ni les documents ni les experts, il raccourcit le chemin entre une question et le passage qui y répond. Quatre capacités partagent le même index.
1. Répondre avec les sources
Capacité cœur de l’assistant : une question en langage naturel, une réponse rédigée, les passages d’origine à portée de clic.
| Fonctionnalité | Ce que fait la plateforme | Ce que ça change |
|---|---|---|
| Questions-réponses sourcées | Retrouve les passages pertinents dans les 3 000 documents, rédige une réponse à partir d’eux seuls et cite chaque document et passage utilisé. | Une réponse vérifiable, pas une opinion de modèle. |
| Ouverture de la source | Chaque citation renvoie au document d’origine, dans Confluence ou SharePoint. | La vérification prend un clic. |
| Questions de suite | Conserve le fil de la conversation pour préciser, approfondir ou comparer. | Un dialogue, pas une succession de recherches. |
| Réponse encadrée | Signale quand la documentation ne contient pas la réponse, au lieu d’inventer. | La confiance se construit aussi sur les silences. |
2. Synthétiser
Pour les documents longs et les sujets couverts par plusieurs documents.
| Fonctionnalité | Ce que fait la plateforme | Ce que ça change |
|---|---|---|
| Résumé d’un document | Produit un résumé structuré d’un rapport ou d’une étude, avec renvoi aux sections. | Un long rapport parcouru avant de l’ouvrir. |
| Synthèse sur un sujet | Rassemble ce que plusieurs documents disent d’un même sujet, en citant chacun. | Une vue d’ensemble, sources à l’appui. |
| Extraction de points clés | Relève les exigences, paramètres ou étapes demandés dans un document. | L’information utile, sans relecture intégrale. |
3. Retrouver et naviguer par sujet
Des sujets diversifiés exigent une organisation lisible : chaque document est classé à l’indexation.
| Fonctionnalité | Ce que fait la plateforme | Ce que ça change |
|---|---|---|
| Classement par sujet | Rattache chaque document et chaque passage à un sujet et à des métadonnées (source, type, date) lors de l’indexation. | Des sujets diversifiés qui restent lisibles. |
| Filtres et facettes | Restreint une question à un sujet, une source, un type de document ou une période. | La bonne réponse dans le bon domaine. |
| Recherche hybride | Combine mots-clés et recherche par le sens, puis reclasse les passages par pertinence sémantique ; acronymes et synonymes compris. | Les documents écrits autrement remontent aussi. |
4. Alimenter et maintenir le socle
L’index vit au rythme de la documentation, sans tâche manuelle.
| Fonctionnalité | Ce que fait la plateforme | Ce que ça change |
|---|---|---|
| Connecteurs Confluence et SharePoint | Synchronisent automatiquement les espaces et bibliothèques retenus : nouveaux documents, mises à jour et suppressions sont répercutés dans l’index. | Un index toujours à jour, sans intervention. |
| Lecture des scans | Passe les documents numérisés par la reconnaissance optique de caractères avant indexation. | Les archives scannées deviennent interrogeables. |
| Pilotage de l’usage | Journalise les questions, les réponses et les sources ; repère les questions sans réponse et les documents les plus cités. | Les lacunes de la documentation deviennent visibles. |
Une question, pas à pas
Vu de l’utilisateur, le parcours tient en six étapes.
- Question : l’utilisateur pose sa question en langage naturel, avec ses termes et ses acronymes, au besoin restreinte à un sujet ou à une source.
- Recherche : l’assistant interroge l’index en mode hybride, mots-clés et sens, ne retient que les passages auxquels l’utilisateur a accès, puis les reclasse par pertinence.
- Réponse : il rédige la réponse à partir de ces passages seuls et cite chaque source ; si rien ne répond, il le dit.
- Vérification : l’utilisateur ouvre le passage d’origine dans Confluence ou SharePoint, en un clic.
- Suite : il précise sa question, demande une synthèse ou signale une réponse incomplète.
- Capitalisation : les questions sans réponse et les retours alimentent la revue de la documentation.
Architecture : un index unique, nourri par Confluence et SharePoint
L’assistant est construit comme une surcouche de la documentation existante, pas comme un nouvel espace de stockage. Il suit le schéma de la génération augmentée par la recherche (RAG) : les documents sont indexés et enrichis en amont, chaque question déclenche une recherche, et le modèle de langage ne rédige qu’à partir des passages retrouvés.
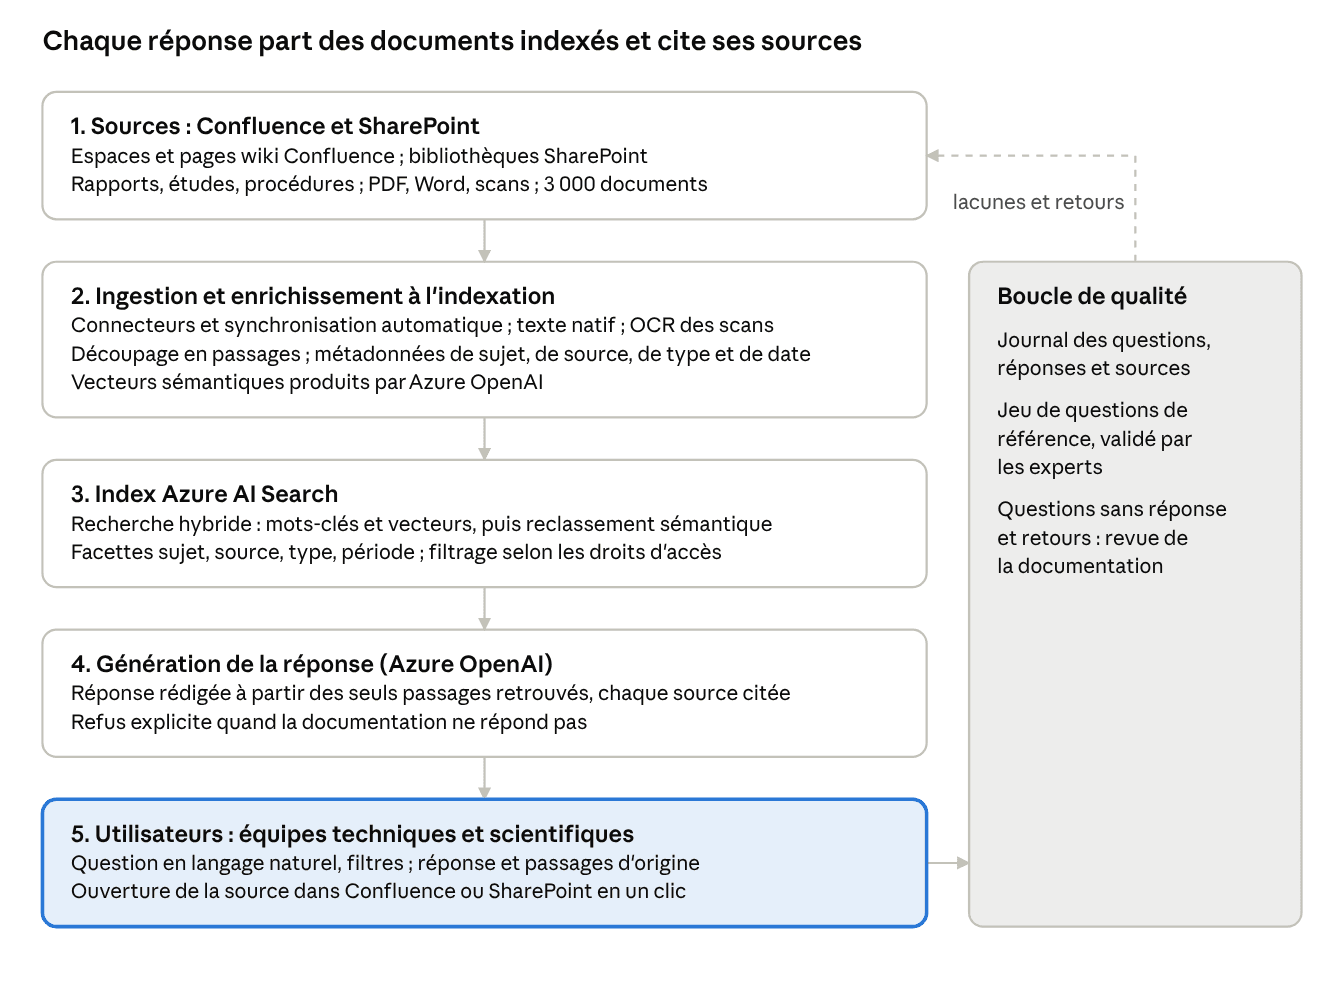
Les connecteurs Confluence et SharePoint lisent les espaces et les bibliothèques retenus et répercutent créations, mises à jour et suppressions. Chaque document passe par une chaîne d’enrichissement à l’indexation : extraction du texte natif, reconnaissance optique de caractères pour les scans, découpage en passages, métadonnées de sujet, de source, de type et de date, et vecteurs sémantiques produits par Azure OpenAI.
Azure AI Search porte l’index : recherche plein texte, recherche vectorielle et recherche hybride, puis reclassement sémantique. Les facettes servent les filtres par sujet, source, type et période ; les droits d’accès sont appliqués à chaque requête, pour que l’assistant ne retrouve que ce que l’utilisateur peut lire.
Azure OpenAI rédige la réponse à partir des passages retrouvés, avec consigne de ne rien affirmer hors de ces passages et de citer chaque source. Les modèles sont déployés dans le tenant Azure du client : les documents et les questions n’en sortent pas.
Un jeu de questions de référence, validé par les experts, mesure la qualité des réponses à chaque évolution de l’index ou des modèles ; questions, réponses et sources sont journalisées. Trois principes guident l’ensemble :
- Ancrage : chaque réponse cite ses passages, et l’utilisateur vérifie à la source.
- Sources vivantes : les documents restent dans Confluence et SharePoint ; l’index les suit, sans copie.
- Qualité mesurée : un jeu de questions de référence et les retours des utilisateurs arbitrent chaque évolution.
Une trajectoire incrémentale : inventaire, pilote, industrialisation, extension
L’assistant a été construit par paliers, chaque étape apportant un bénéfice vérifiable avant la suivante.
- Cadrage et inventaire documentaire : recensement des espaces Confluence et des bibliothèques SharePoint, des formats, des sujets et des droits ; choix du périmètre pilote.
- Pilote sur un domaine : un sujet, un groupe d’experts et un jeu de questions de référence pour mesurer la pertinence et ajuster le découpage et l’enrichissement.
- Industrialisation : connecteurs et synchronisation automatique, droits d’accès, journalisation, infrastructure décrite en code et pipelines de déploiement.
- Extension à l’ensemble des sujets : montée progressive aux 3 000 documents et aux équipes techniques et scientifiques, avec la synthèse et la navigation par sujet.
Gouvernance et conformité : des réponses vérifiables, des accès respectés
Un assistant qui répond sur des documents techniques engage ceux qui s’en servent. La plateforme a été conçue pour que chaque réponse puisse être vérifiée et chaque accès justifié :
- Ancrage et sources citées : aucune réponse sans passage d’origine ; l’utilisateur vérifie à la source.
- Droits d’accès : les autorisations de Confluence et de SharePoint s’appliquent à chaque requête ; personne n’obtient de réponse à partir d’un document qu’il ne peut pas lire.
- Données maîtrisées : documents, index et modèles dans le tenant Azure du client, en Union européenne.
- Traçabilité : questions, réponses et sources journalisées.
- Qualité mesurée : jeu de questions de référence validé par les experts, retours des utilisateurs, suivi des questions sans réponse.
Des bénéfices sur le terrain
Le premier résultat est un changement de réflexe : la question remplace la navigation entre les espaces. Ce que les équipes en retirent :
- Une réponse au lieu d’une recherche : le passage utile arrive avec la réponse, sans ouvrir dix documents.
- Des sujets diversifiés sous un seul point d’entrée : les 3 000 documents, quels que soient leur source et leur format, répondent à la même question.
- Une connaissance partagée : les réponses ne dépendent plus de la disponibilité des experts ; leur savoir écrit sert à tous.
- La confiance par la source : chaque réponse se vérifie en un clic.
- Une documentation qui s’améliore : les questions sans réponse désignent ce qu’il faut écrire ou mettre à jour.
Ce qui a fait la différence
- La documentation avant le modèle : inventaire, périmètre et droits traités comme un chantier à part entière ; la qualité des réponses dépend d’abord de celle des sources.
- Les sources citées comme règle : pas de réponse sans passage d’origine, et un refus explicite quand rien ne répond.
- Partir d’un domaine, étendre sur le même socle : un sujet pilote avec ses experts, puis les autres sujets sans changer d’architecture.
- Mesurer avec les experts : un jeu de questions de référence qui arbitre chaque évolution de l’index ou des modèles.
Vers l’IA agentique
Le socle d’index et de garde-fous ouvre la voie à des usages plus actifs : une récupération agentique, où un agent décompose une question complexe en sous-requêtes exécutées en parallèle avant la synthèse ; des agents capables d’agir à partir de la réponse, préparer un rapport, ouvrir une demande, notifier un expert ; de nouvelles sources, systèmes documentaires et outils métier ; une recherche multimodale sur les schémas et les plans. La démarche reste la même : une capacité à la fois, mesurée et validée par les équipes.