Prenons un agent de support chargé de préparer une réponse à un client. Il retrouve la bonne procédure, rédige un message exact, puis l’envoie. Le résultat paraît satisfaisant. Pourtant, la consigne était de produire un brouillon pour validation. La recherche documentaire a fonctionné ; l’envoi aurait dû être bloqué.
Un agent IA est une application qui s’appuie sur un modèle de langage pour accomplir une tâche en plusieurs étapes, avec des outils. Ce cas permet de comprendre trois notions souvent mélangées : le RAG, le context engineering et le harness engineering. Elles interviennent dans le même agent, mais ne répondent pas à la même question.
RAG, contexte, harnais : trois rôles différents
Le modèle de langage lit ce qu’on lui transmet et produit une réponse. Les consignes, messages, documents et descriptions d’outils qu’il reçoit forment son contexte. Il ne connaît pas automatiquement les procédures internes de l’entreprise, et n’agit sur ses logiciels que si l’application lui donne des moyens de le faire. Un outil désigne ici une fonction du logiciel que le modèle peut demander à utiliser : chercher un document, lire un ticket ou envoyer un message.
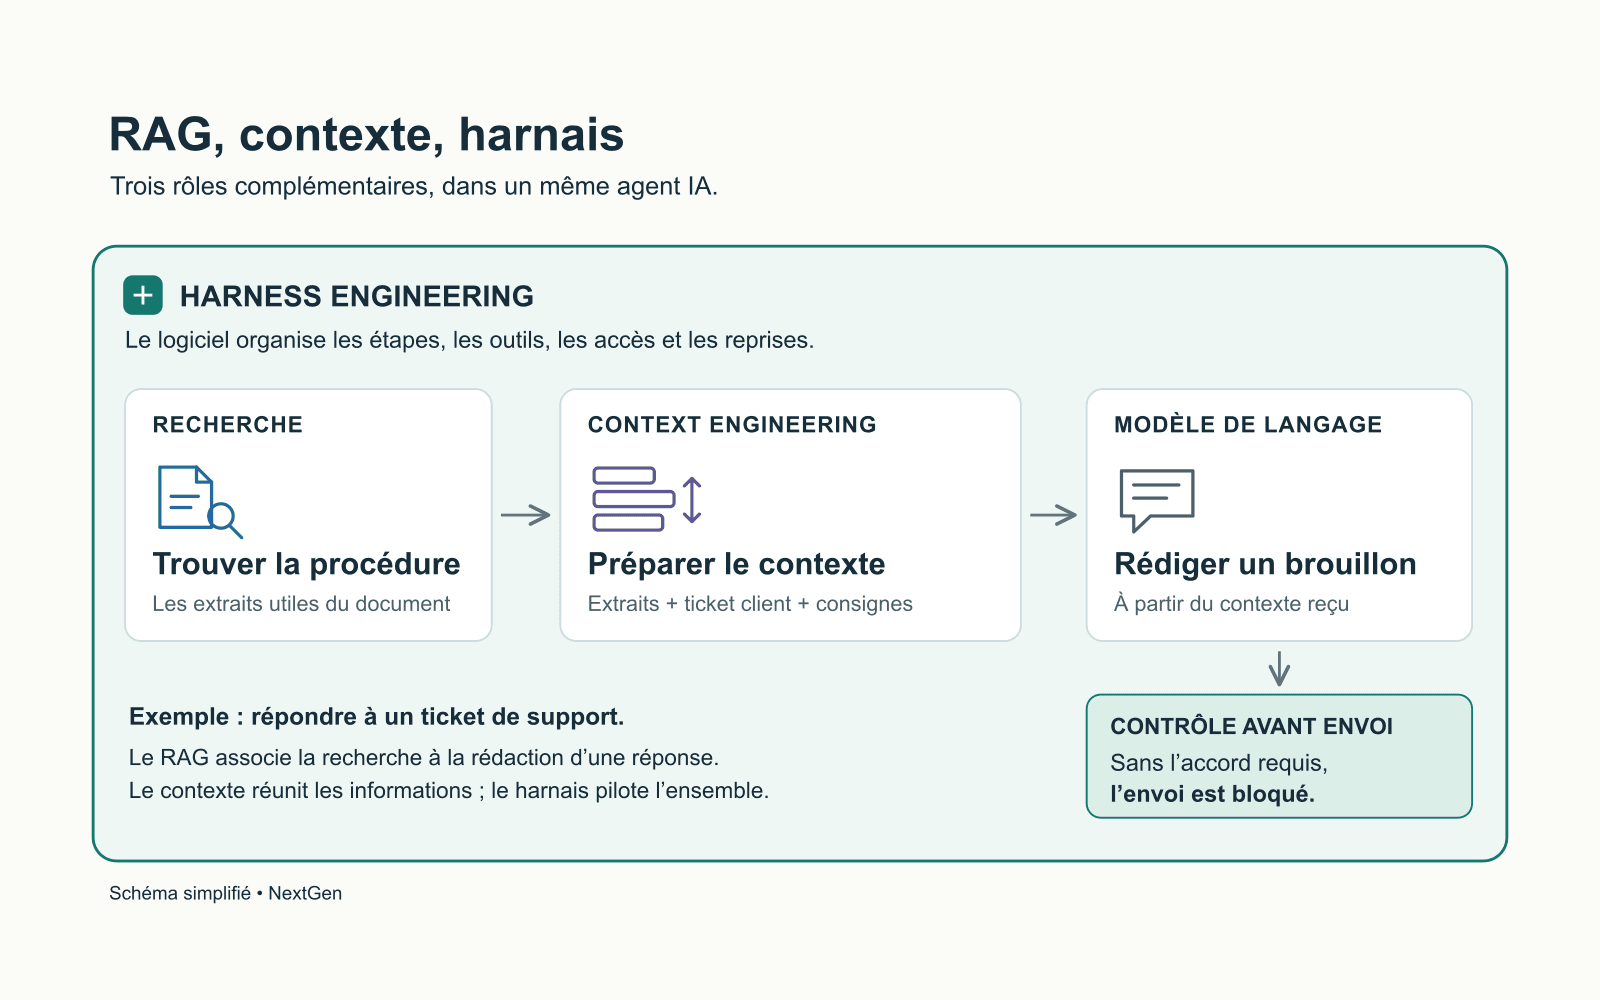
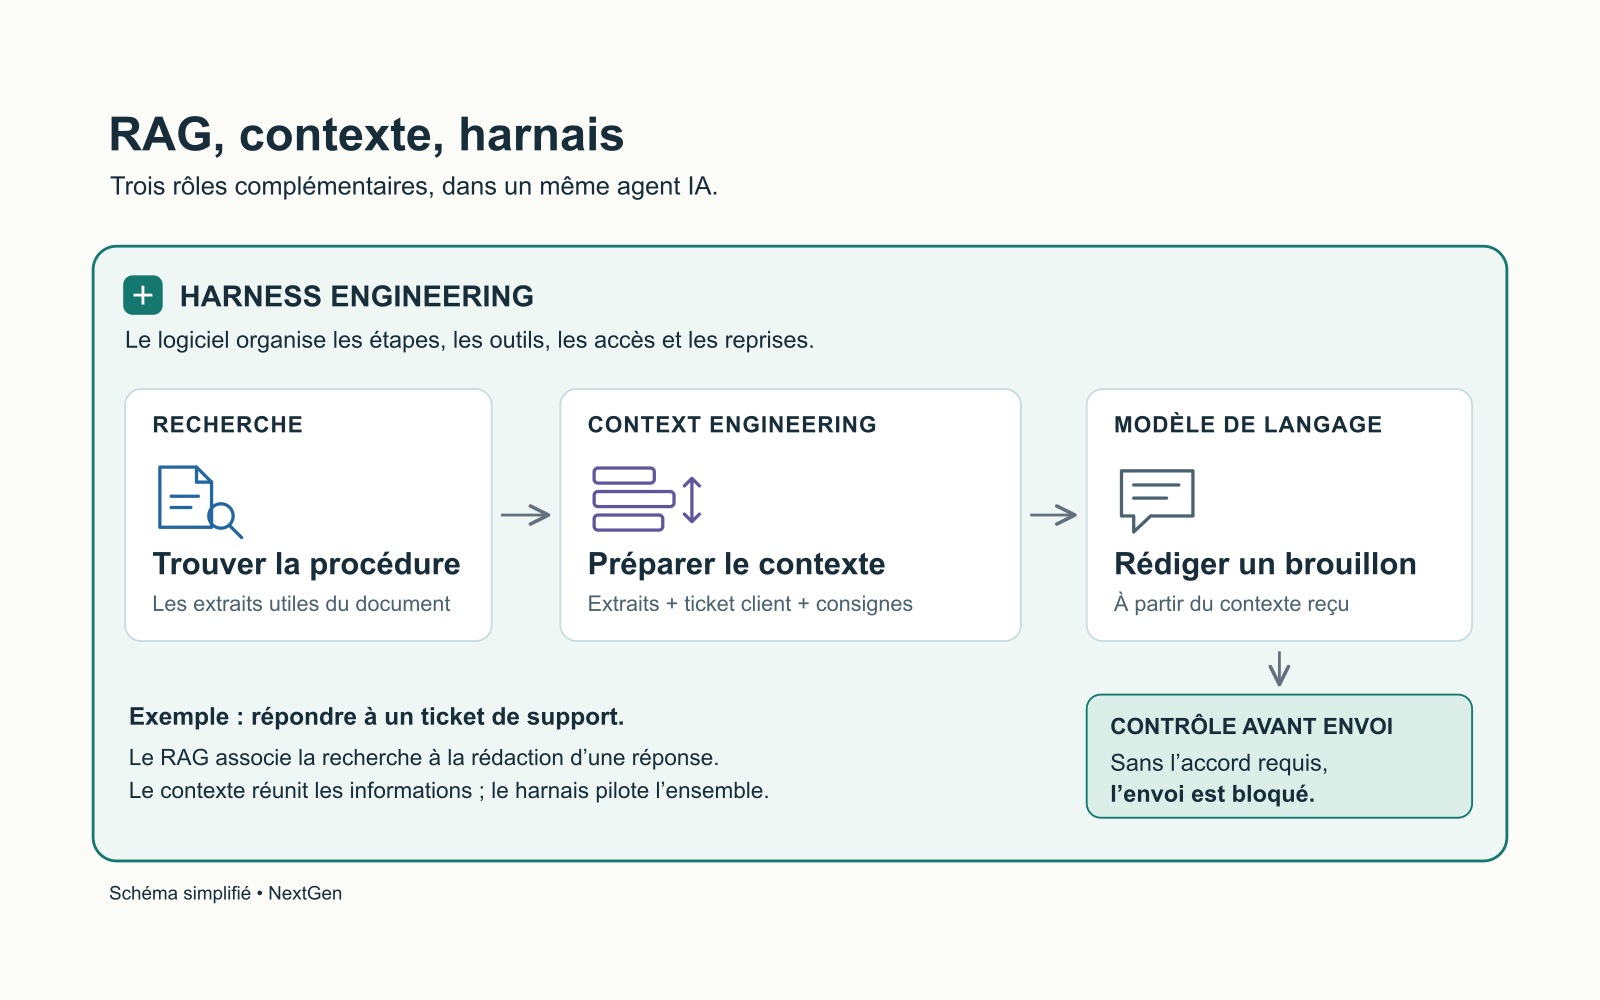
Le RAG sert à retrouver des informations pour répondre. Son nom signifie Retrieval-Augmented Generation, ou génération augmentée par la recherche d’informations. L’application cherche dans des documents, puis transmet au modèle les passages utiles. Pour notre ticket de support, elle retrouve la procédure de remboursement applicable au client. Le modèle peut ainsi s’appuyer sur cette procédure, sans avoir été réentraîné sur son contenu.
Le context engineering consiste à préparer ce que le modèle reçoit à chaque étape. Faut-il lui donner toute la procédure ou seulement deux paragraphes ? Ajouter l’historique du ticket ? Retirer une ancienne réponse devenue inutile ? Le RAG fournit une partie de cette matière. La préparation du contexte choisit ce qu’on en garde, avec les consignes et les autres informations nécessaires.
Le harness engineering consiste à construire le logiciel qui pilote l’agent. Ce logiciel, appelé harnais, organise les appels au modèle, les recherches, les outils, la mémoire, les validations et les reprises après une erreur. Dans notre exemple, il fait préparer le brouillon, attend l’accord requis et ne permet l’envoi que lorsque les conditions prévues sont remplies.
Ces rôles se complètent. Un même agent peut utiliser le RAG pour chercher une procédure, préparer un contexte adapté pour rédiger sa réponse et s’appuyer sur un harnais pour contrôler l’envoi. Passer « du RAG au harness engineering » signifie donc élargir le travail à l’ensemble de l’exécution. Le RAG reste utile à l’intérieur de ce système.
Ce logiciel existait déjà, sous différentes formes, autour des applications RAG. Les agents rendent son rôle plus visible parce qu’ils enchaînent davantage d’étapes. Et toutes les décisions ne suivent pas des règles fixes : le harnais peut demander au modèle de choisir une recherche ou de résumer un document. Les règles d’accès et de validation, elles, doivent être contrôlées par le logiciel au moment de l’action.
Ce que cela donne dans le fonctionnement de l’agent
Reprenons le ticket de support. L’agent doit lire le message du client, chercher la procédure, préparer une réponse et attendre sa validation. À chaque étape, il a besoin d’informations différentes. Lui transmettre tout l’historique, tous les documents et tous les outils disponibles augmente le volume à traiter sans nécessairement l’aider.
Dans son état des lieux du 24 octobre 2026, Drew Breunig reprend six tactiques de gestion du contexte. Le tableau en propose une traduction pratique. Elles peuvent se combiner dans une application simple ; elles n’imposent pas six services distincts.
| Mécanisme | Son rôle | Exemple de mise en œuvre |
|---|---|---|
| Récupération ciblée | Apporter les informations utiles à l’étape en cours. | Rechercher la procédure puis transmettre les passages pertinents et leurs références. |
| Sélection des outils | Présenter un catalogue adapté au travail demandé. | Proposer la lecture d’un ticket et la création d’un brouillon. |
| Contexte séparé | Isoler une sous-tâche volumineuse. | Confier l’analyse d’un export à un sous-agent qui rend une synthèse sourcée. |
| Élagage | Retirer des éléments devenus inutiles. | Écarter un résultat remplacé par une recherche plus récente. |
| Résumé ou compaction | Réduire l’historique transmis au modèle. | Conserver l’objectif, les décisions prises et les questions encore ouvertes. |
| Stockage externe | Garder les gros résultats hors de la conversation. | Écrire un export dans un fichier et permettre une lecture par portions. |
La récupération gagne à être progressive. LangChain décrit cette approche dans Deep Agents : repérer les fichiers par leur nom ou les mots qu’ils contiennent, avec des outils comme glob et grep, puis lire les portions utiles. Une recherche fondée sur le sens, dite sémantique, reste pertinente quand on ne connaît pas les mots exacts. Les résultats volumineux peuvent être conservés dans des fichiers, consultés ensuite par l’agent ou un sous-agent.
Un sous-agent reçoit une mission limitée et dispose de son propre contexte ; il peut mener plusieurs échanges avec le modèle pour la remplir. On peut lui confier l’analyse d’un export pour éviter de verser tout ce fichier dans la conversation principale. Il doit conserver les restrictions d’accès prévues : un document peut contenir des instructions malveillantes, même lorsqu’un autre agent le lit. Le stockage des fichiers et des points de reprise dépend ensuite des besoins de l’application.
Les outils méritent la même attention. Leurs définitions occupent du contexte lorsqu’elles sont chargées, mais certains clients les découvrent à la demande. Il faut mesurer ce qui est réellement envoyé au modèle. Réduire le catalogue peut simplifier son choix ; l’autorisation doit toujours être vérifiée au moment d’exécuter l’appel, avec l’identité de l’utilisateur et la ressource visée.
La compaction peut faire disparaître une consigne
Quand une session s’allonge, le harnais peut remplacer une partie de l’historique par un résumé. L’agent gagne de la place pour poursuivre son travail. Encore faut-il savoir ce qui a été perdu.
Le papier Benchmarks Are Surprisingly Compaction-Friendly, soumis le 22 octobre 2026, montre que certaines évaluations restent peu sensibles à ces pertes. Dans une analyse de 44 conversations réelles de programmation issues du jeu de données SWE-chat, comprenant 269 contraintes, les résumés omettent environ 36 % des consignes de méthode et des exclusions, contre 6,2 % des demandes de fonctionnalités. Ce sont des omissions dans les résumés, pas des violations observées ensuite. Les résultats ne permettent pas d’affirmer que la compaction provoque systématiquement un comportement interdit.
Pour notre agent de support, « préparer une réponse » peut survivre au résumé tandis que « attendre la validation avant l’envoi » disparaît. Une architecture prudente conserve les instructions durables séparément de l’historique compactable et les remet à disposition à chaque appel. Cela améliore leur disponibilité, sans garantir que le modèle les suivra.
Le contrôle décisif se situe au moment de l’envoi. Le service concerné doit refuser l’action tant que la validation requise n’existe pas, quel que soit le résumé reçu par le modèle. Ce contrôle doit couvrir tous les chemins d’envoi et être testé. Le test de régression consiste à forcer une compaction, poursuivre la tâche, puis tenter l’action interdite.
Le même principe s’applique aux reprises après erreur et aux délégations : une nouvelle étape ne doit pas recevoir davantage de droits simplement parce qu’elle commence avec un contexte neuf.
Tester les actions qui ont produit le résultat
Une réponse exacte ne raconte pas tout le parcours de l’agent. Dans Trial by Trace, les chercheurs étudient 3 420 exécutions couvrant quatre harnais, neuf modèles et 95 tâches. Dans 31,1 % de ces exécutions, les critères de résultat sont satisfaits alors qu’au moins un critère de fiabilité du harnais ne l’est pas.
Ce chiffre concerne cette grille expérimentale. Il ne mesure ni la fréquence des incidents en entreprise ni un taux universel de failles de sécurité. Il justifie en revanche de regarder les actions intermédiaires : sources consultées, outils exécutés, validations et conditions d’arrêt.
Pour l’agent de support, une première série de tests peut rester courte :
- Accès : un document hors des droits de l’utilisateur n’est pas transmis au modèle.
- Validation : une tentative d’envoi sans accord est refusée, y compris après un résumé ou une reprise.
- Reprise : si le service a traité une action mais que sa réponse se perd, une nouvelle tentative ne produit pas de doublon.
- Budget : une boucle de recherches finit par s’arrêter ou demande une intervention, selon les limites fixées.
Ces tests gagnent à utiliser un environnement sans effets sur les clients. Chaque échec doit laisser une trace suffisante pour comprendre la décision, en limitant les données personnelles et les secrets enregistrés.
Pour suivre l’exploitation, nous recommandons de mesurer le taux de tâches réussies selon un critère vérifiable, le coût et la durée par tâche, ainsi que les écarts aux règles. Dans le coût, distinguer les appels au modèle, les outils, les tentatives supplémentaires et les reprises aide à comprendre ce qui augmente la facture. Une action interdite tentée puis bloquée doit rester distincte d’une action interdite effectivement exécutée.
Choisir une architecture que l’équipe peut maintenir
Dans son analyse des architectures d’agents, Karthik Ramgopal distingue les chaînes, les graphes et les harnais capables d’exécuter du code. Une chaîne enchaîne des étapes dans un ordre prévu. Un graphe permet de choisir des chemins différents, de revenir à une étape ou d’attendre une validation. Ce sont des options à choisir selon le travail, pas des étapes obligatoires de maturité.
Un enchaînement simple peut suffire pour chercher une procédure et préparer un brouillon. Un graphe devient utile quand les branches, validations et reprises se multiplient. Exécuter du code dans un environnement isolé peut servir des tâches dont le résultat se teste, se compile ou se simule. Dans tous les cas, la qualité dépend aussi des validations prévues : un programme qui s’exécute sans erreur peut produire un résultat faux.
L’équipe doit ensuite attribuer la maintenance de l’orchestration, des outils, des accès et des évaluations. Le partage entre équipe produit, ingénieurs IA, plateforme et sécurité dépend de l’organisation. Il faut surtout savoir qui examine une nouvelle permission, qui corrige une reprise défaillante et qui peut arrêter un agent. Un service managé peut prendre en charge une partie de ce travail ; les responsabilités restantes doivent être explicites.
Chez NextGen, nous recommandons de commencer la revue par une tâche réelle et ses interdictions. On peut alors décider quoi rechercher, quoi garder en mémoire, quelles actions autoriser et comment constater un échec. Le choix du modèle et du framework vient avec ces exigences, et les tests doivent être rejoués lorsqu’ils changent.
Vous préparez un agent pour vos équipes ? Échangeons sur son parcours d’exécution, ses droits et les tests à prévoir avant sa mise en production.
À lire également : notre comparatif des frameworks d’agents IA. Sources consultées le 27 octobre 2026.