Le 5 octobre, un client demande à être appelé le matin. Le 26, il précise : « Cette semaine, je ne suis disponible qu’après 16 h. » Le lendemain, un assistant doit proposer un rendez-vous pour cette même semaine. S’il consulte une fiche qui indique seulement « préfère le matin », il risque de se tromper. S’il retrouve les deux messages et leurs dates, il peut tenir compte de l’exception.
Cet exemple fictif pose une question concrète : que faut-il conserver pour qu’un agent IA puisse reprendre un échange sans perdre ce qui compte ? Une étude récente, consacrée à Raw-RAG, apporte des résultats utiles. Elle invite surtout à mesurer ce qu’une solution simple sait déjà faire avant de lui ajouter une mémoire plus complexe.
La mémoire d’un agent, c’est quoi exactement ?
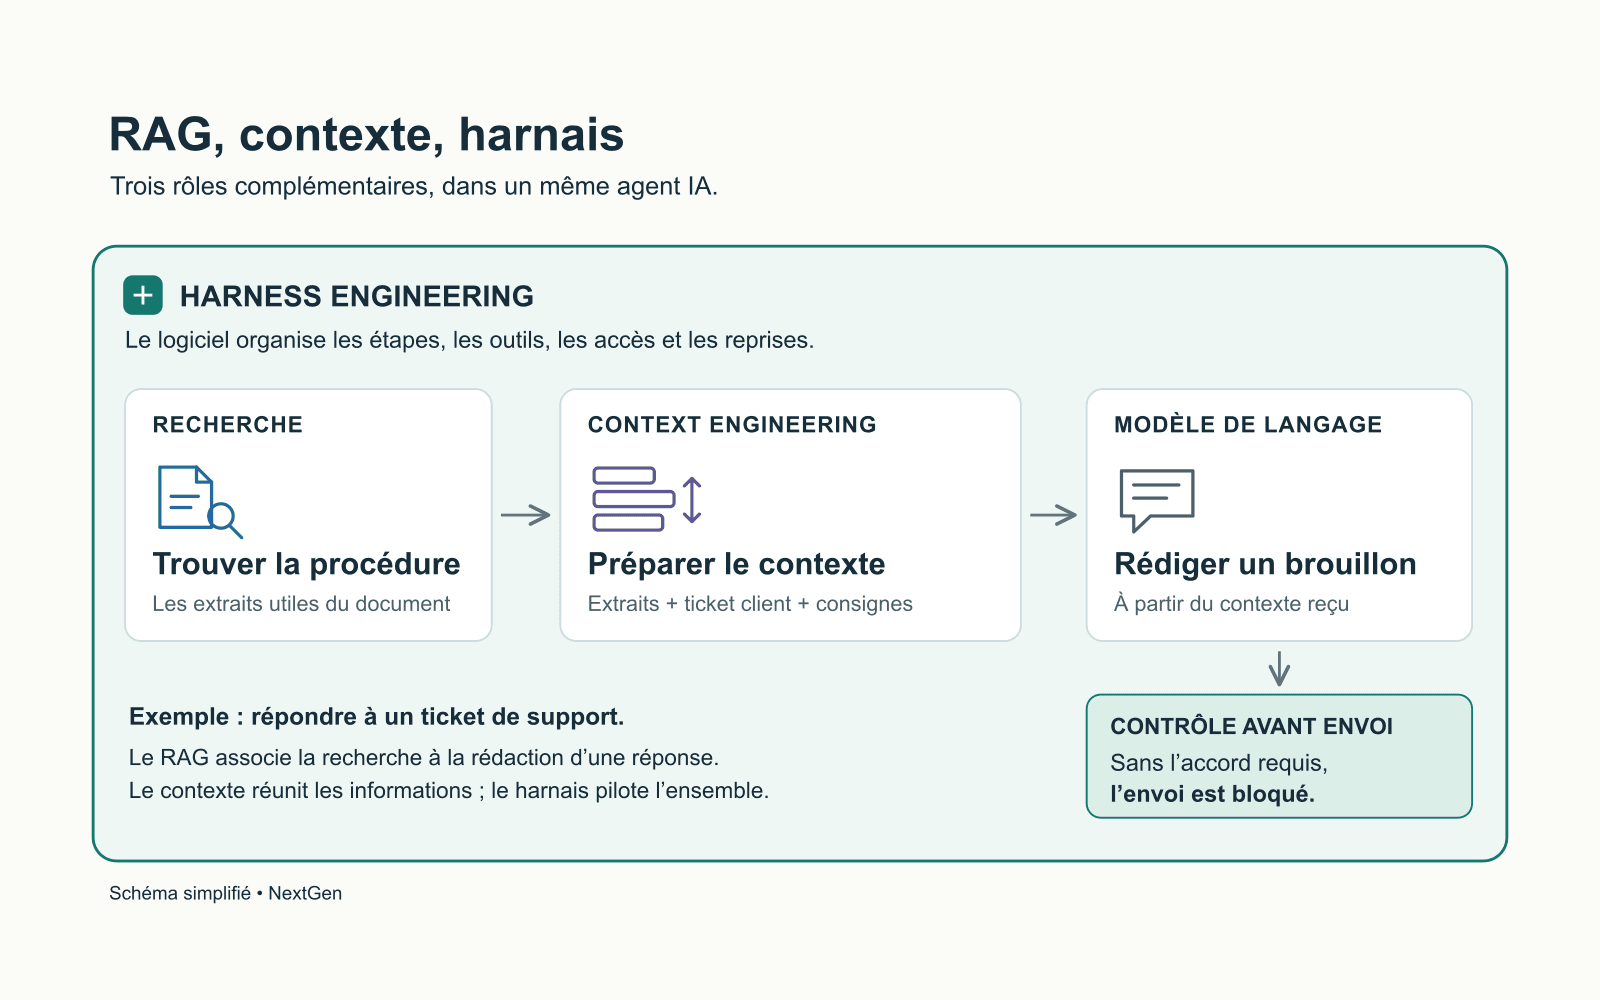
Dans les applications dont il est question ici, la mémoire est constituée d’informations enregistrées par le logiciel. Le modèle ne relit pas automatiquement toutes les anciennes conversations. À chaque étape, l’application choisit ce qu’elle lui transmet : c’est son contexte. Une information peut donc être stockée sans être transmise au modèle pour préparer sa réponse.
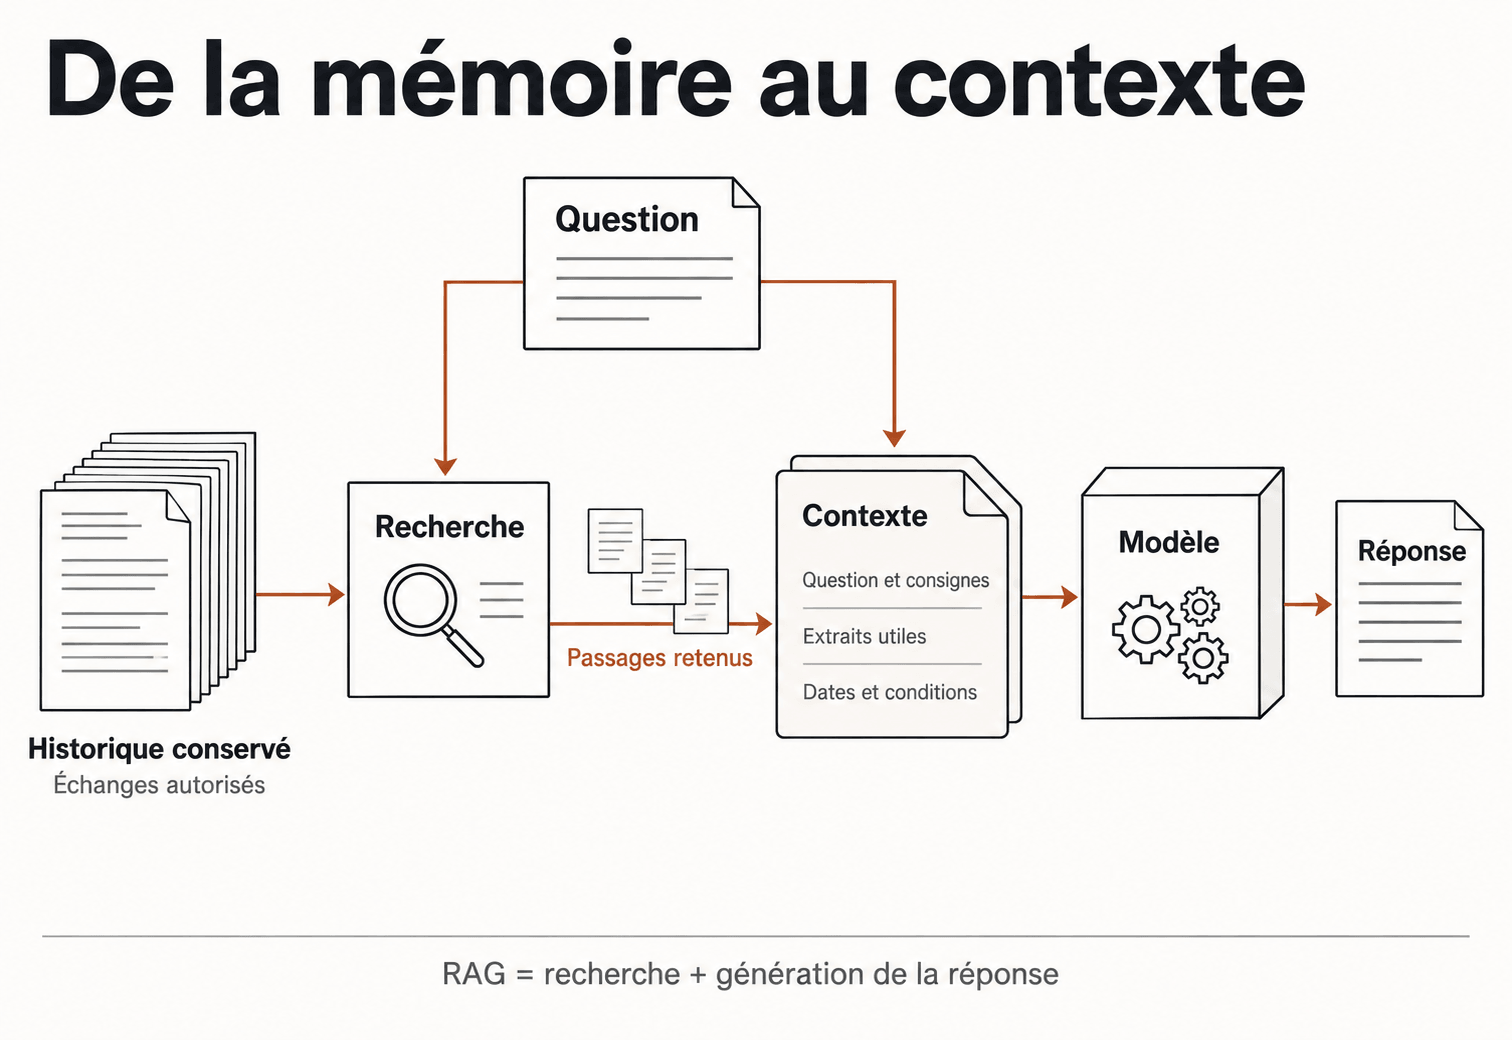
Le RAG associe recherche d’informations et génération d’une réponse. Pour une mémoire conversationnelle, l’application retrouve des passages des échanges précédents, puis le modèle s’appuie sur eux pour répondre. Une autre approche consiste à extraire d’abord des faits, à résumer les échanges ou à organiser leurs relations. Ces opérations peuvent faciliter la consultation, mais elles doivent préserver les dates, les conditions et les corrections utiles.
Ce que montre Raw-RAG, et ce qu’il ne montre pas
Dans Is Complex Agentic Memory Always Needed?, déposé le 22 octobre 2026, Bao et ses coauteurs évaluent Raw-RAG face à plusieurs systèmes de mémoire. Les messages d’origine sont découpés, recherchés puis reclassés selon leur pertinence. Les passages retenus sont généralement élargis aux échanges complets avant d’être transmis au modèle. Il n’y a ni résumé préalable ni extraction de faits.
Dans la comparaison principale, Raw-RAG arrive premier parmi les systèmes de mémoire dans six configurations sur sept. Ce classement exclut la méthode qui transmet tout l’historique au modèle. Celle-ci fait mieux sur certains tests. Les écarts avec les autres mémoires sont parfois faibles.
Une comparaison supplémentaire, présentée en annexe, nuance aussi le résultat : sur PersonaMem-v2, Raw-RAG arrive troisième sur sept. Les expériences portent sur des conversations enregistrées ; elles ne valident pas toutes les contraintes d’un service en production. « Simple » signifie ici qu’on transforme peu l’historique, pas qu’on supprime le travail de recherche et de classement.
Un résumé peut perdre une condition importante
Reprenons notre rendez-vous. Une fiche qui conserve uniquement la préférence du 5 octobre n’est pas assez précise pour répondre le 27. Mais remplacer cette préférence par « disponible après 16 h » serait également trompeur : l’exception ne vaut que pour une semaine.
On peut conserver une information structurée utile, à condition de noter sa portée : préférence habituelle, exception temporaire, date de confirmation et message d’origine. La structure n’est pas le problème en elle-même. Le risque vient d’une simplification qui retire ce dont une prochaine question aura besoin.
Garder les messages ne suffit pas non plus. Le moteur de recherche peut manquer l’échange du 26 octobre ; le modèle peut mal interpréter « cette semaine ». Une vérification doit donc porter à la fois sur les passages retrouvés et sur la réponse produite.
L’historique prouve ce qui a été dit, pas que tout ce qui a été dit est vrai. Pour savoir si une facture a été réglée, l’agent doit consulter le système de facturation. Une ancienne phrase dans une conversation ne remplace pas cet état à jour. Pour une préférence personnelle devenue incertaine, il peut demander une confirmation. Cette distinction évite de transformer une erreur passée en fait établi.
Trois besoins de mémoire à distinguer
Une équipe peut commencer par séparer les usages suivants. Ils n’exigent pas forcément trois bases de données différentes.
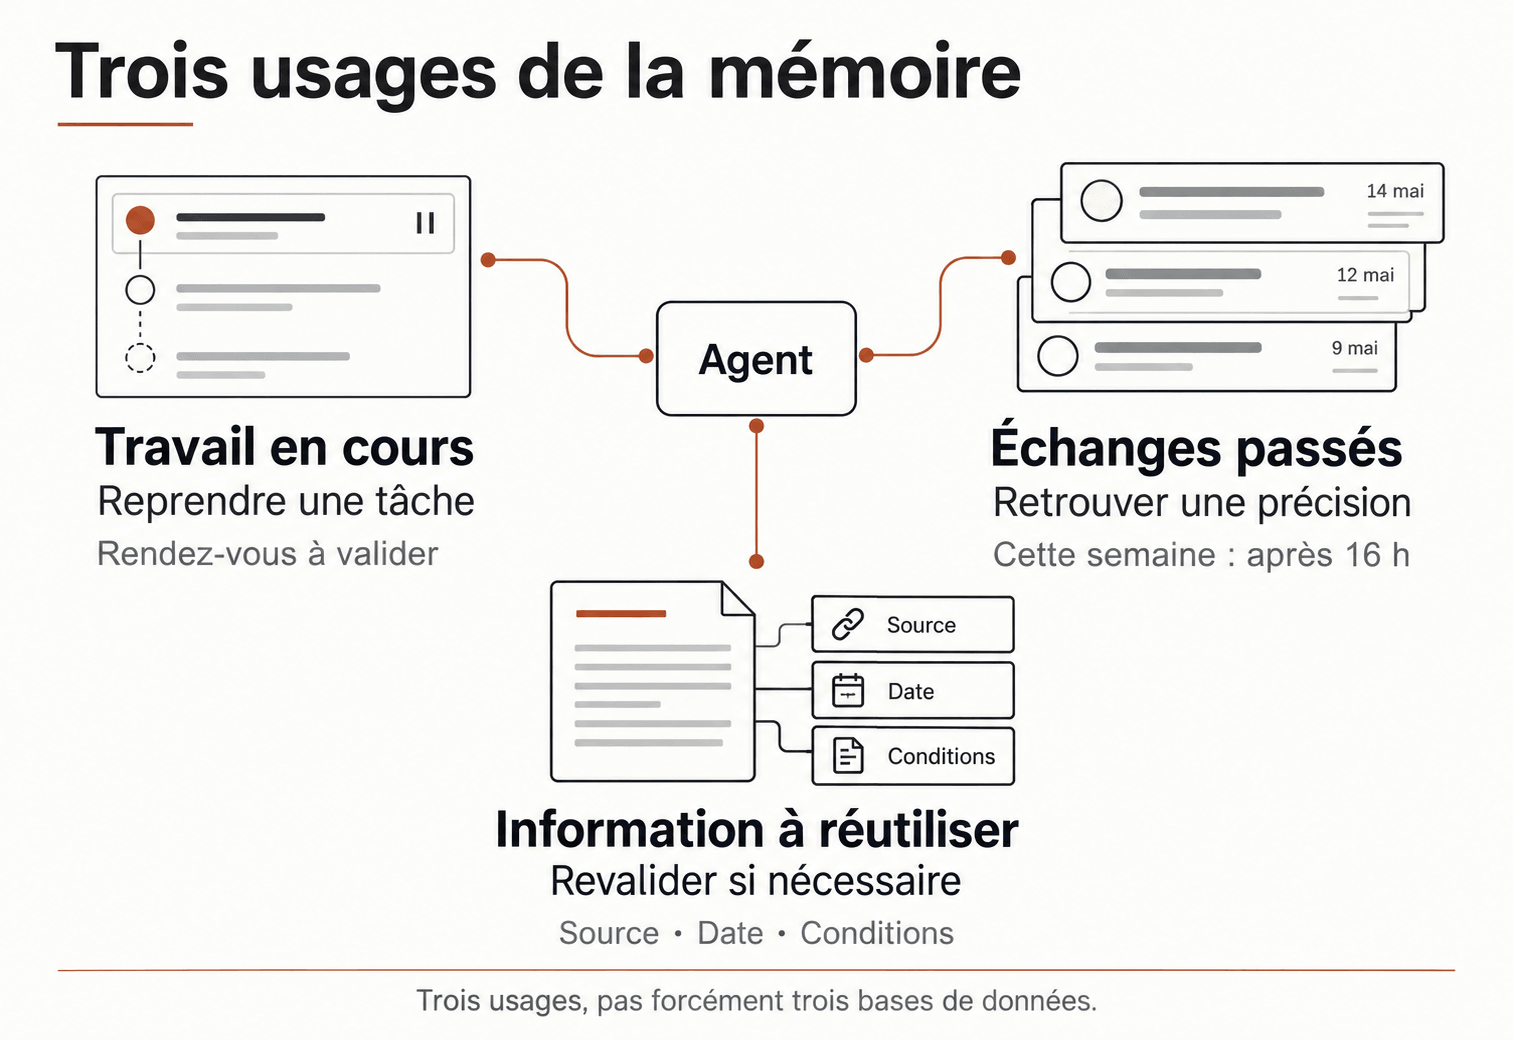
LangGraph distingue notamment la sauvegarde de l’état d’une conversation et le stockage d’informations utilisables entre plusieurs conversations. Cette organisation aide à reprendre le travail ; les droits de lecture et de modification restent à configurer séparément. Un identifiant de conversation n’est pas une autorisation d’accès.
Pour chaque information conservée, il faut savoir qui peut la consulter, combien de temps elle reste utile et comment la corriger. Une date de dernière confirmation ne garantit pas sa validité actuelle. Selon le cas, l’agent doit revenir vers l’utilisateur ou consulter le système métier concerné.
Conserver l’historique ne veut pas dire tout garder
Avant d’enregistrer des conversations, l’équipe doit définir les données nécessaires au service et une durée de conservation adaptée. Ce sont notamment les principes de minimisation et de limitation de la conservation posés par l’article 5 du RGPD. Garder tous les échanges sans limite augmente aussi le volume de données personnelles à protéger. Une mémoire plus complète n’est donc pas automatiquement une meilleure architecture.
Le droit à l’effacement prévu par l’article 17 du RGPD comporte des conditions et des exceptions. Lorsqu’une demande doit être satisfaite, retirer un message de l’écran ne suffit pas à traiter toutes ses copies. Il faut examiner les passages indexés pour la recherche, les faits et résumés dérivés, les caches, ainsi que les journaux et sauvegardes concernés. Cette liste dépend de l’application. Des règles de conservation distinctes peuvent s’appliquer à certains éléments.
Une expiration automatique peut aider à appliquer la durée prévue. Elle ne remplace pas une procédure d’effacement qui couvre les données concernées. Un test utile consiste à supprimer une information autorisée pour le test, puis à vérifier qu’elle n’est plus proposée par les recherches ni réintroduite lors d’une reprise ou d’une restauration.
Comparer avant d’ajouter une couche de mémoire
Pour choisir, nous recommandons de partir de questions proches de celles que l’agent recevra. Une première version peut rechercher dans les échanges dont la conservation est justifiée. On la compare ensuite à une version avec résumés ou faits structurés, en gardant le même modèle et en contrôlant les volumes d’informations transmis.
Le jeu d’essai doit contenir des situations qui obligent réellement à utiliser la mémoire :
- Une exception datée : la disponibilité temporaire du client doit être respectée pendant la période concernée.
- Une correction : une nouvelle adresse remplace l’ancienne sans être confondue avec celle d’un autre client.
- Une information absente : l’agent demande une précision au lieu d’inventer.
- Un accès refusé ou une suppression : les passages concernés ne doivent plus être transmis au modèle.
Pour chaque réponse, examiner la source utilisée aide à comprendre l’erreur : passage introuvable, contexte incomplet ou mauvaise interprétation. Il faut aussi mesurer le délai de réponse, le coût des traitements et le travail nécessaire pour corriger ou supprimer une information.
Une mémoire structurée peut être le bon choix si elle améliore ces résultats ou répond à un besoin précis de l’application. L’essentiel est de pouvoir montrer ce qu’elle apporte et de garder la possibilité de corriger ce qu’elle retient.
À lire également : RAG, contexte et harness engineering : qui fait quoi ?